Zeka Ucuzken Farkındalık Değerli: Yapay Zeka Performansı ve İnsan Üretiminin Değeri
Makineler artık neredeyse hiçbir maliyet olmadan yazıyor, hesaplıyor ve tavsiyelerde bulunuyor. Zekâ bu kadar ucuz olduğunda, insanlar için hâlâ neyin…
Özet
Makineler artık neredeyse hiçbir maliyet olmadan yazıyor, hesaplıyor ve tavsiyelerde bulunuyor. Zekâ bu kadar ucuz olduğunda, insanlar için hâlâ neyin bedel ödemeye değer? Makalemizin cevabı farkındalık: Langer’ın tanımladığı gibi, yeni şeyleri aktif olarak fark etme eylemi. Bu cevap iki iddiaya dayanıyor: makineler fark etmez ve insanlar fark etme eylemi için ödeme yapar. Her ikisini de test ettik. Makineler fark eder mi? 2026’da internette yayılan şu soruyu düşünün: “Arabamı yıkamak istiyorum. Araba yıkama yeri 50 metre uzakta. Yürümeli miyim yoksa arabayla gitmeli miyim?” İlk sistematik testte, önde gelen modellerin çoğu yürümeyi önererek arabayı evde bıraktı. Arşivlenmiş 4.240 yanıt arasında GPT-5.5 ve Fable 5, dokuz soruluk bir test setinin tamamındaki 90 denemenin hepsini geçti. Diğer modeller bir soruyu çözüp bir sonrakini kaçırdı; keşif amaçlı bir karşılaştırmada ise dört modelden üçü, bir ajan çerçevesi içinde düz bir komut satırına kıyasla daha kötü performans gösterdi. Araba yıkama sorusunu yanlış cevaplayan beş modele “fark etmelerini” söylemek —insanlardaki önyargıları azaltan bir talimatla bile— 400 denemede sadece dokuz doğru sonuç verdi. Hedefi açıkça belirtmek bazı modelleri tamamen düzeltirken diğerlerinde hiçbir etki yaratmadı. İnsanlar fark etme eylemi için ödeme yapar mı? Önceden kaydedilmiş iki deney (N = 1.006 ve N = 589) kapsamında katılımcılardan yapay zekâ veya insan tarafından üretilen altı ürün için ne kadar ödeyecekleri soruldu. İnsan bir üretici, insanların ödemeye razı oldukları bedeli yaklaşık iki katına çıkardı (+%103). Bu insanın aktif bir muhakeme yürüttüğünü belirtmek ek olarak %20,9’luk bir artış sağladı. Ancak yaratıcı bir muhakeme yapmadan sadece prosedürleri takip ettiği belirtilen bir insan bile yapay zekâdan %53,8 daha fazla bedel çekti. Katılımcılar ayrıca insan yapımı ürünlerin daha iyi olmasını bekliyorlardı; bu da primlerin bir kısmını açıklayabilir. Her iki cevap da basit bir “evet” veya “hayır”dan çok daha ilgi çekicidir. Makinelerde farkındalık bir özellikten ziyade bir haritadır: bir modelin bir şeyi fark edip etmemesi soruya, yönlendirmeye ve etrafındaki yazılıma bağlıdır; bu nedenle değerlendirmeler her modelin hangi ayrıntıları kullandığını haritalandırmalıdır. İnsanlarda ise farkındalık, insan olmanın getirdiği büyük bir primin üzerine ek bir bedel taşır. İnsan emeğinin değerini koruması için makinelerin başarısız olmasına gerek yoktur.
Giriş
“Arabamı yıkamak istiyorum. Araba yıkama tesisi 50 metre uzakta. Yürümeli miyim, yoksa arabayla mı gitmeliyim?” Yürümek mesafeyi kat etmeyi sağlar ancak arabayı geride bırakır. Bu soruyu biz icat etmedik. Soru, Şubat 2026’nın başlarında Çince çevrimiçi forumlar ve haberler aracılığıyla yayıldı, ancak tanımlanabilir bir kaynağı bulunamadı (facelezz, 2026; Sina Tech, 2026). Burada kullanılan İngilizce ifade, Kévin (@knowmadd) tarafından 15 Şubat 2026’da paylaşılan bir Mastodon gönderisinden alınmıştır (2026). İlk sistematik testi ise Wunderlich (2026) gerçekleştirdi; bu testte önde gelen 53 modelin çoğu yürümeyi önerdi. Sonraki çalışmalar, hatanın belirgin bir mesafe ipucunun, belirtilmemiş hedefin önüne geçmesinden kaynaklandığını ortaya koydu (Li ve diğerleri, 2026). Ayrıca, modelin hedefi öncelikle belirtmesini zorlayan yönlendirmelerin bu sorunu düzeltebildiği gösterildi (Jo, 2026a). Soru, özel bir uzmanlık bilgisi gerektirmiyor; tek ihtiyacı, yolculuğun amacını bilmek.
Bu tür başarısızlıklar, acil bir soruya yanıt veriyor gibi görünüyor: Makine zekâsının maliyeti düştükçe (Cottier ve diğerleri, 2025), insanlar için neyin hâlâ ödeme yapmaya değer olduğu ne olacak? Doğal bir yanıt —ve başlığımızdaki yanıt— farkındalıktır: Makineler, neyin önemli olduğunu fark etmeden yanıtlar üretir; insanlar ise bunu yapabilen birine ödeme yapacaktır. Bu yanıt iki iddiaya dayanır: Birincisi, yapay zekânın neyin önemli olduğunu fark etmediği; ikincisi ise insanların insan emeğini seçerken farkındalığa değer verdiği. İlk iddia, yapay zekânın nasıl değerlendirildiğini şekillendirirken, ikincisi insan emeğinin nasıl savunulduğunu ve fiyatlandırıldığını etkiler. Biz her ikisini de test ettik.
Langer’in açıklamasına göre farkındalık, sadece daha yoğun dikkat göstermek değildir. Bu, aktif bir farkındalıkdir: yeni ayrımlar yaratmak, yeni bilgilere açık kalmak, birden fazla bakış açısını görmek ve geçmişte oluşturulmuş kategorilere katı bir şekilde bağlı kalmak yerine bağlama göre yanıt vermek (Langer, 1989). Bu durum, yapay zekâ değerlendirmesi için sınırlı bir soru ortaya koyar: Bir yanıt, ne yapılması gerektiğini değiştiren ayrıntıları kullanıyor mu? Biz, farkındalığın tam psikolojik durumunu değil, bu gözlemlenebilir performansı inceliyoruz.
Güçlü kıyaslama performansı, basit varyantlardaki ve kompozisyonel problemlerdeki başarısızlıklarla bir arada var olabilir (Dziri vd., 2023; Nezhurina vd., 2024). İstem formatındaki küçük değişiklikler doğruluğu değiştirebilir (Sclar vd., 2024); ayrıca, tek bir ögelerde yardımcı olan yapılandırılmış bir istem, daha uzun bir üretim istemi içinde etkisini kaybedebilir (Jo, 2026b). Alışılmış bir problem, ezberlenmiş cevabın artık geçerli olmayacağı şekilde değiştirildiğinde performans da düşer (Wu vd., 2024; McCoy vd., 2024). İstemler, planlama veya öz-doğrulama problemlerini güvenilir bir şekilde çözemez (Kambhampati vd., 2024). Üretilen açıklamalar ise yeni bir tuzak yaratır: bir cevabın nedenini ortaya koymak yerine, sonradan onu meşrulaştırabilirler (Turpin vd., 2023; Lanham vd., 2023; Arcuschin vd., 2025; Boppana vd., 2026).
Bu nedenle, davranışı neyin değiştirdiğini soruyoruz. Genel bir farkındalık çağrısı yardımcı olur mu? İnsanlarda bu etkili olabilir: katılımcılardan üç yeni unsuru fark etmelerini istemek, 22 standart bilişsel önyargıdan 19’unu azaltmıştır (Maymin ve Langer, 2021); metabilişsel istemler ise bazı dil modeli kıyaslamalarında iyileşme sağlamıştır (Wang ve Zhao, 2024). Gözden kaçan bir nesnenin veya hedefin adını vermek daha mı etkilidir? Bir etki başka bir soruya veya modele de taşınır mı? Daha genel olarak, bir cevabı hangi ayrıntılar kontrol eder ve bu hangi istemler ile yazılım ayarları altında gerçekleşir?
Arşivlenmiş 4.240 yanıt üzerinden değerlendirildiğinde, farkındalık bir kişilik özelliğinden ziyade bir harita gibi görünüyordu. Araba yıkama sorusunu yanlış cevaplayan beş modele farkındalık çağrısı yapmak —insanlarda önyargıları azaltan talimatla birlikte bile— nadiren işe yaradı; hedefin adını vermek ise bazen bir modeli tamamen düzeltti. Ancak bu düzeltmeler diğer sorulara güvenilir bir şekilde yansımadı ve hatta bazen tersine döndü. Haziran ayına gelindiğinde, iki model dokuz soruluk bir test serisinin tamamını geçti. Tek bir puanlama, tüm bu durumu gizlerdi; çünkü bir modelin hedefi kaçırıp kaçırmadığını, beklediği tanıdık bir soruyu mu cevapladığını yoksa gerçekten verilen ayrıntıları mı kullandığını ayırt edemezdi.
Langer’ın araştırma programından daha önceki deneyler, materyalin büyük bir kısmı sabit kalsa bile sürece önem vermenin bir nedenini sunuyor. Langer (1989, s. 145–146) tarafından rapor edilen iki çalışmada, rollerini kullanarak performans sergileyen oyuncular ve standart bir satış metniyle çalışan ansiklopedi satıcılarından, performanslarına veya müşterilerine ya yeni bir yaklaşım sergilemeleri ya da mümkün olduğunca tutarlı olmaları istendi. İzleyiciler ve müşteriler, daha esnek performans sergileyenleri daha karizmatik olarak değerlendirdi; müşteriler ayrıca bu satıcıları daha bilgili olarak nitelendirdi, her ne kadar ürün bilgileri arasında bir fark olmasa da. Aynı Rotary Club metnini kullanan kadınlar, metni kendilerine özgü hale getirmeleri istendiğinde daha samimi olarak algılandı; soğuk sunum karşılaştırmalarında ise daha iyi liderler olarak değerlendirildi (Kawakami ve diğerleri, 2000). Orkestra müzisyenleri, tanıdık eserleri ya daha önce başarılı olmuş bir performansı yeniden yaratmaya çalışarak ya da ince yeni dokunuşlar ekleyerek icra ettiler. Talimatları bilmeyen dinleyiciler, ikinci kayıtları tercih etti (Langer ve diğerleri, 2009). Koşullu dil kullanılarak, örneğin “olabilir” ve “olabilir” şeklinde öğretilen bir modeli öğrenen öğrenciler, bu modeli mutlak dille öğretilen öğrencilere göre daha esnek bir şekilde kullandılar (Langer ve diğerleri, 1989). Ortak nokta basittir: Bir metin büyük ölçüde aynı kalabilirken, bir kişinin bu metne yaklaşma şekli değişebilir ve diğer insanlar bazen bu farkı duyabilir veya görebilir.
İkinci sorumuz ekonomik nitelikte. Ekonomik modeller, makine tahminlerinin ucuzlamasının insan muhakemesinin göreceli değerini artırdığını öngörüyor (Agrawal ve diğerleri, 2018). Biz bu öngörüyü test etmiyoruz. Bunun yerine, bundan doğal olarak çıktığı varsayılan daha dar bir hipotezi test ediyoruz: İnsanlar insan emeği için daha fazla ödeme yaptıklarında, aslında insanın getirdiği muhakeme için ödeme yapıyorlar. Ancak insanlar bir şeyin kim tarafından ve nasıl yapıldığına hâlâ önem verebilir. Önceki çalışmalar, özellikle sembolik veya estetik değeri olan ürünlerde insan emeğine ve insan yapımı sanata yönelik tercihlerin bulunduğunu göstermiştir (Granulo ve diğerleri, 2021; Longoni ve Cian, 2022; Bellaiche ve diğerleri, 2023; Rix ve diğerleri, 2025). Otantiklik, yaratıcı süreçle ilgili inançlar, beklenen kalite, çaba, kimlik ve ahlaki endişeler bu tercihlere katkıda bulunabilir (Kruger ve diğerleri, 2004; Newman ve Bloom, 2012; Fuchs ve diğerleri, 2015; Millet ve diğerleri, 2023; Hu ve diğerleri, 2026). Ayrıca, tıbbi muhakemelerde yapay zekâya karşı direncin iyi belgelenmiş olduğu da bilinmektedir (Longoni ve diğerleri, 2019). İki farklı tanımlama karşılaştırmasını test ediyoruz: insan yapımı ile yapay zekâ yapımı arasındaki fark ve muhakeme yürüten bir insan ile standart prosedürleri izleyen bir insan arasındaki fark. Önceki performans çalışmalarının aksine, katılımcılar eşdeğer çıktılarla karşılaşmadılar. Dolayısıyla deneylerimiz, insanların tanımlamalardan ne beklediğini ve neye değer verdiğini test ediyor; bir ürünün yaratılış sürecindeki bilinçli çabayı tespit edip edemediklerini değil.
Önceden kaydedilmiş iki deney, altı ürün için beyan edilen ödeme isteğini ölçtü. Genel bir “insan yapımı” tanımı, yapay zekâ tanımıyla karşılaştırıldığında değerlendirmeleri yaklaşık olarak iki katına çıkardı. Ürünü yapan insanın aktif muhakemelerde bulunduğunun belirtilmesi, standart prosedürleri izleyen bir insana kıyasla %20,9’luk bir artış sağladı. Ancak yaratıcı muhakeme kullanmadığı belirtilen standart prosedürleri izleyen insan bile yapay zekâdan %53,8 daha fazla değer gördü. Model verileri, ilk iddianın bazı modeller, komutlar ve ayarlar için geçerli olduğunu, ancak diğerleri için geçerli olmadığını gösteriyor. Tüketici verileri ise ikinci iddianın yalnızca kısmen doğru olduğunu ortaya koyuyor: Tanımlanan muhakeme bir prim yaratmış olsa da, katılımcıların insan yapımı ürünler için ödedikleri tutarın büyük bir kısmı bu muhakemeye bağlı değildi. Bu iki bulgunun ardındaki mekanizmanın aynı olduğunu iddia etmiyoruz; her biri ortak bir argümanın yalnızca bir yarısını test etmektedir.
Materyaller ve yöntemler
Ne kabul edilebilir sayılır
Model deneyleri basit bir soruyu ele alıyor: Cevap, önemli olan ayrıntıyı kullandı mı? Her sonuç; model adı, görev, komut, yazılım ayarı, tarih ve değerlendirme kuralıyla birlikte, arşivde mevcut olması halinde sağlayıcı tarafından döndürülen model sürümüyle de raporlanıyor. “Geçme” durumu, bir yanıtın o görev için arşivlenmiş kuralı karşıladığı anlamına geliyor. Toplam 4.240 çağrı; ilk komut deneyindeki 1.000 çağrıyı, komut-görev deneyindeki 870 çağrıyı, ana test serisindeki 1.170 çağrıyı, ek ayar-pilot veya kontrol çağrılarından oluşan 840 çağrıyı ve değiştirilmiş ayrıntılı çağrılardan oluşan 360 çağrıyı içeriyor. Bazı deneylerde görevler ve modeller yeniden kullanıldığından, bu toplamlar bağımsız tekrarlamalar değildir.
Komut deneyleri
Mart ayında gerçekleştirilen komut deneyi, 10 koşulu beş modelle ve her hücrede 20 çağrıyla birleştirdi. Modeller, basit araba yıkama sorusunu yanıtlamada başarısız oldukları için seçildi. Koşullar şunlardı: temel düzeyde bir sıfır-atımlı düşünce zinciri talimatı (Wei ve diğerleri, 2022; Kojima ve diğerleri, 2022); yeni şeyleri fark etme, özgün ayrımlar yapma ve koşullu “olabilir” diline dayanan, Langer’dan esinlenmiş dört genel farkındalık talimatı (Langer ve Piper, 1987; Langer, 1989; Langer ve Moldoveanu, 2000) ile insanlarda bilişsel önyargıları azaltmak için kullanılan “üç yeni şeyi fark et” talimatı da dahil olmak üzere (Maymin ve Langer, 2021); nesneleri, hedefleri veya başarısızlık simülasyonunu ortaya çıkaran üç yapısal komut —sonuncusu premortem tekniğinin bir versiyonuydu (Mitchell ve diğerleri, 1989; Klein, 2007)— ve tek cümlelik bir format kontrolü. Arşiv tüm yanıtları ve koşul etiketlerini içeriyor, ancak istek betiğini, zaman damgalarını, örnekleme parametrelerini veya sağlayıcı tarafından döndürülen model tanımlayıcılarını içermiyor. Bu nedenle, tam metin tutarlı talimat yankılarından yeniden oluşturulmuş ve Ek B.2’de buna göre etiketlenmiştir.
Göreve yönelik istem deneyinde araba yıkama, buzdolabı ve aşırı tuzlu çorba görevleri kullanıldı. Altı istem temel düzeydeydi: fiziksel durumu tanımlamak (bkz. Deng vd., 2023; Weston ve Sukhbaatar, 2023); hedefi ve gerekli fiziksel koşulu belirtmek (bkz. Zheng vd., 2024); durup düşünmek; işin püf noktasının ne olduğunu sormak; ardından cevap verip kendi kendine kontrol etmek (bkz. Weng vd., 2023; Madaan vd., 2023). Son üçü günlük dilde verilen talimatlardır; diğerleri ise yayımlanmış istem stratejilerinin uyarlamalarıdır. Haiku 4.5 (Anthropic, San Francisco, CA, ABD; Mart) ve GPT-5.4-nano (OpenAI, San Francisco, CA, ABD; Haziran) her hücre başına 20 çağrı aldı. GPT-4o-mini (OpenAI, San Francisco, CA, ABD; Mart) ise beş istem koşulunda 10 çağrı aldı. Görev metinleri, istemler, hücre sayıları ve değerlendirme kuralları Ek B.3’te yer almaktadır.
Haziran ayı bataryası, değiştirilmiş detay sorguları ve yazılım ayarları
Haziran ayı bataryası, üretim API’si üzerinden dokuz OpenAI modeli ve minimal bir başsız Claude Code komut satırı çağrısı aracılığıyla dört Anthropic modeliyle dokuz görevi tamamladı; her hücre başına 10 çağrı yapıldı. Yazılım ayarı ile modelin soruyu aldığı yolu kastediyoruz: API, minimal komut satırı veya ajan çerçevesi. OpenAI arşivi istemi, yanıtı, zaman damgasını, token kullanımını, hata alanını, bitiş nedenini ve sağlayıcı tarafından döndürülen model tanımlayıcısını saklamaktadır. Akıl yürütme sınıfındaki OpenAI modelleri için 6.000 tokenlık bir çıktı limiti belirlenmişti. Anthropic çağrıları, sabit bir araçsız giriş metniyle birlikte aynı kullanıcı-görev metnini kullandı. Satıra göre model adları telemetriden, komut satırı takma adından veya modelin kendi bildiriminden gelmektedir; çağrı manifestosu kaynağı belirtmektedir.
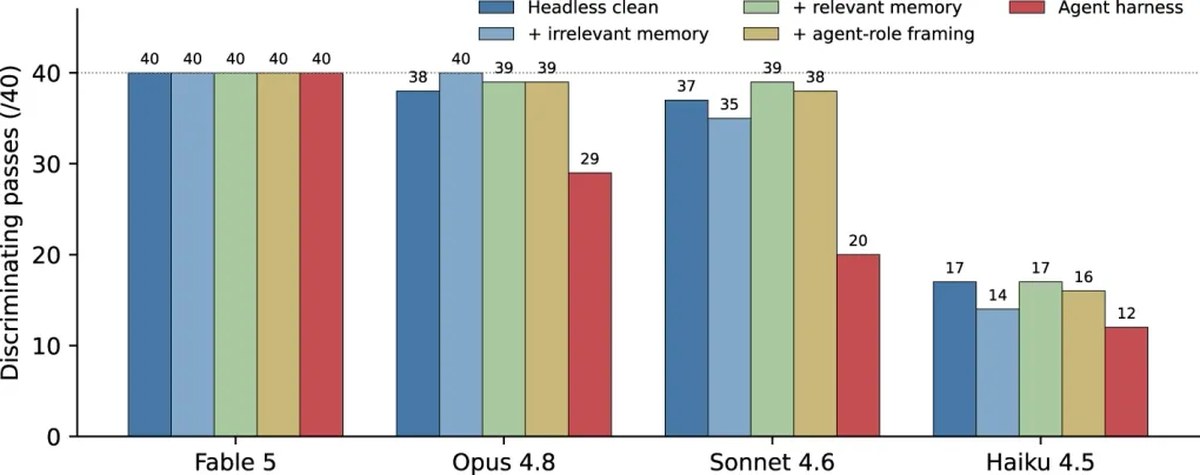
840 ek yazılım ayarı çağrısı, 360 çağrıdan oluşan dokuz görevli bir ajan çerçevesi pilot çalışması ve üç adet 160 çağrılı başsız kontrol sisteminden oluşmaktadır. Şekil 1, pilot çalışmanın dört görevlik alt kümesinden alınan 160 yanıtı, 480 kontrol yanıtını ve ana denemede zaten sayılmış olan 160 minimum başsız yanıtı karşılaştırmaktadır. Çerçeve ve başsız ayarlar rastgele belirlenmediği ve eklenen metnin ötesinde farklılıklar içerdiği için bu karşılaştırma keşif amaçlıdır. Değiştirilmiş detaylara yönelik dört tur sonda çalışması ardışık olarak geliştirilmiş, her hücre için 5–20 çağrı kullanılmış ve bunlar da benzer şekilde keşif amaçlıdır.
Göreve özgü kurallar öncelikle her yanıtı “geçer”, “geçersiz” veya “belirsiz” olarak sınıflandırmıştır. Haziran ayındaki OpenAI arşivi için yazarlardan biri (P.Z.M.), arşivlenmiş kriterleri kullanarak 76 belirsiz vakaya (810 vakanın %9,4’ü) karar vermiştir.
Ardından, OpenAI’nin 734 net kural kararından 90 tanesinden oluşan sabit, göreve göre katmanlandırılmış bir örneklemi OpenAI Codex ile kontrol ettik. İki karar 90 vakanın 87’sinde (%96,7; Wilson %95 güven aralığı %90,7–%98,9) uyumluydu; üç uyumsuzluk ise kurala ilişkin yanlış negatif sonuçlardı. Örneklem kasıtlı olarak ek başarısızlıkları içerdiğinden, %96,7’lik oran tüm 734 kararı değil, denetim örneklemini temsil etmektedir. Codex, kural etiketlerini görebildiğinden, bu bağımsız bir insan güvenilirlik kanıtı değil, model destekli ve kör olmayan bir kontroldü.
Anthropic yazılım ayarı analizleri için aynı yazar, model ve ayar görünür durumdayken tüm 800 yanıtı değerlendirdi. Ardından yeni bir Fable 5 örneği, yalnızca kriteri ve ham yanıtı kullanarak katmanlandırılmış üç adet %20’lik örneklemden oluşan toplam 160 yanıtı yeniden değerlendirdi. Uyum oranları sırasıyla 63/64, 63/64 ve 31/32 idi (Cohen’s κ = 0,963, 0,943 ve 0,871). Bir yanıt kendi kendini düzelttiğinde, nihai cevabı değerlendirmeyi belirledi. Kriterler arasında, aracın oto yıkamaya ulaşması, imkansız bir saat konfigürasyonunun imkansız olarak adlandırılması, buzdolabının fiziksel olarak sığması, patates emilimi efsanesinin reddedilmesi ve yumurta maddesindeki zamirin cevabı belirlemesi gibi gereklilikler bulunuyordu. Tam kriterler, satır düzeyindeki değerlendirmeler, denetim seçimleri ve kaynak sınırlamaları Ek B ve C’de yer almaktadır.
Tüketici deneyleri ve etik
Her iki tüketici çalışması da Prolific platformunda, en az %95 onay oranına sahip, 18 yaş ve üzeri ABD sakinleri arasında yürütülmüştür. Katılımcılar çevrimiçi bilgilendirilmiş onam vermiştir. Fairfield Üniversitesi Kurumsal İnceleme Kurulu, araştırmayı 4592 sayılı Protokol kapsamında onaylamıştır.
Çalışma 1’de katılımcılar, Prolific kimliklerinin deterministik bir hash fonksiyonuyla isimli zanaatkar, genel insan veya yapay zeka üretici tanımına atanmıştır. Her katılımcı ekmek, cilt lezyonu teşhisi, resim, müzik albümü, makale/makale ve seramik kase için maksimum ödeme isteğini (WTP) ve beklenen kaliteyi belirtmiştir. Her iki çalışmada da her ürün, aynı zamanda referans fiyatı olarak da işlev gören tipik bir perakende fiyatıyla sunulmuştur: ekmek için 6 $, teşhis için 150 $, resim için 200 $, müzik albümü için 10 $, makale için 5 $ ve seramik kase için 35 $. Bu görüntülenen fiyatlar tüm koşullarda aynıydı, ancak beyan edilen ödeme isteğini yönlendirmiş olabilir. Orijinal makaleyle birlikte sunulan Ek Materyalde fiyatların gösterilmediği hatalı bir şekilde belirtilmişti; Ek Ek D.2 bu düzeltmeyi belgelemektedir. Kamuoyuna açık OSF kaydı (https://osf.io/rts67/, 26 Şubat 2026’da kaydedildi) analizi yönetmektedir. Dışlamalar arasında aritmetik yanıtlarda hata, koşul hatırlamada başarısızlık, 60 saniyeden kısa tamamlama ve yinelenen kimlik (ilk tutulan hariç) yer almıştır. Ödeme isteği, her referans fiyatın 10 katıyla sınırlandırılmış ve ardından ürün içi birleşik %2,5 ve %97,5’lik persentillerde winsorize edilmiştir. Ürünler, referans fiyatlarına bölündükten sonra eşit ağırlıklandırılmıştır. Koşul hatırlama hataları arasındaki fark %10’dan fazla olduğu için, bu dışlama yapılmadan gerçekleştirilen kaydedilmiş analiz de raporlanmıştır.
Çalışma 2’de yeni katılımcılar aktif değerlendirme için insan, standartlaştırılmış insan veya yapay zeka tanımlarına atanmıştır. Çalışmanın AsPredicted kaydı (#279021; 14 Mart 2026’da kaydedildi), aritmetik hatalar ve 60 saniyeden kısa tamamlama nedeniyle dışlama gerektirmiş, ödeme isteği her referans fiyatın beş katıyla sınırlandırılmış ve winsorizasyon uygulanmamıştır. Koşul hatırlama hataları işaretlenmiş, ancak dışlanmamıştır. Ürün sonuçları Çalışma 1’deki gibi normalleştirilmiş ve eşit ağırlıklandırılmıştır.
Tüketici yanıtlarını nasıl analiz ettik
Çalışma 1’de, insan vs. yapay zeka ve zanaatkar vs. genel insan karşılaştırmaları için yönlü Welch testleri kullanılmış ve altı ürün üzerinden Holm düzeltmesi uygulanmıştır; Cohen’in d değeri birleştirilmiş standart sapmalara dayanmaktadır. Kayıtlı alan analizi, genel kesri, genel-insan-yapay-zeka üstünlüğü ile zanaatkar-yapay-zeka üstünlüğü oranının bölümü olarak tanımlamıştır. Bu kesrin ürünler arası standart sapması 10.000 kez bootstrap yöntemiyle yeniden hesaplanmış ve kesrin üç fonksiyonel/deneyimsel ürün için üç yaratıcı/simgesel ürüne kıyasla daha yüksek olacağı tahmini test edilmiştir. Kalite analizlerinde çift yönlü Welch testleri ve JZS Bayes faktörleri (r = 0.707) kullanılmıştır. Varyans analizlerinde medyan merkezli Levene/Brown–Forsythe testleri uygulanmıştır. Tüm hücreler kayıtlı normallik kontrolünden geçemediği için Mann–Whitney sonuçları da sunulmuştur. Ham, sınırlamasız ve aşırı katılımcı duyarlılıkları da eklenmiştir.
Çalışma 2’de, Welch karşılaştırmaları için kayıtta belirtilen çift yönlü α = 0.05 kuralı kullanılmıştır. Kayıt, iki bitişik karşılaştırmayı bir süreç-köken ayrıştırması olarak adlandırmış ve altı ürün düzeyindeki oranları kullanmıştır. Bu etiket oldukça güçlüdür: standartlaştırılmış-insan-yapay-zeka tanımı da süreç dilini değiştirdiği için üretici kökenini tek başına izole etmez. Kayıtlı yaratıcı-gradyan testi, kategori başına üç ürün düzeyindeki oranı karşılaştırmıştır. Katılımcı düzeyindeki yaratıcı-fonksiyonel karşılaştırma ise açıkça keşif amaçlıdır.
Katılımcı düzeyindeki koşul karşılaştırmalarında katılımcı bağımsız birim olarak kullanılırken; kayıtlı ürün düzeyindeki testlerde yukarıda belirtilen altı ürün özeti kullanılmıştır. Hiçbir model çağrısı anlamlılık testi bağımsız bir kanıt kaynağı olarak ele alınmamıştır. Analiz kodu ve makine tarafından okunabilir çıktılar bu makaleye eklenmiştir.
Sonuçlar
“Fark et” demek, araba yıkama hatasını nadiren düzeltti
İlk deney, araba yıkama sorusuyla ilgili 10 prompt, beş model ve her hücrede 20 tekrarlanan çağrıyı kapsadı (toplam 1.000 çağrı; Şekil 2). Arşivlenmiş örnekteki basit soruyu beş modelin tamamı yanıtlamıştı; bu nedenle bu deney, modellerin temsili bir incelemesi değil, bir düzeltme deneyidir. Langerian dil yaklaşımından uyarlanan dört prompt, sistemin varsayımları fark etmesini, üç yeni unsur belirlemesini, yeni farklılıklar çıkarmasını veya sorunun “ne anlama gelebileceğini” düşünmesini istedi (Langer, 1989; Maymin ve Langer, 2021). Bu promptlar 400 denemede dokuz başarılı yanıt (yüzde 2,25) üretti; buna karşılık, sade formülasyonlu 100 denemede hiç başarılı yanıt elde edilemedi (iki taraflı Fisher kesin p = 0,216). İnsanlarda 22 bilişsel önyargıdan 19’unu azaltan “üç yeni unsur fark etme” talimatı 100 denemede 5 başarılı yanıt sağladı. “Düşünce zinciri” talimatı ise 100 denemede yalnızca bir başarılı yanıt üretti. Herhangi bir formülasyon değişikliğinin yanıtı etkileyip etkilemediğini kontrol etmek için eklenen tek cümlelik kontrol grubu da 100 denemede 5 başarılı yanıt verdi ve bunların tamamı Haiku 4.5’ten geldi. Genel “fark etme” promptları ise kısalık talebinden daha iyi bir sonuç vermedi.
Daha spesifik talimatlar daha iyi sonuçlar verdi, ancak yalnızca bazı modellerde. Hedefe ulaşmak için fiziksel olarak neyin gerekli olduğu sorusu 100 denemede 41 başarılı yanıt; yanıtın hedefe ulaşamadığını hayal etme talimatı 29/100; yanıt vermeden önce fiziksel nesneleri listeleme talimatı ise 22/100 başarılı yanıt sağladı. Bu üç prompt genelinde Claude Haiku 4.5 ve GPT-4o, 120 denemeden 91’inde (yüzde 75,8) başarılı yanıt verirken, diğer üç model 180 denemeden yalnızca 1’inde (yüzde 0,6) başarılı oldu. Hedef belirleme promptları bu soruyu daha önceki çalışmalarda zaten düzeltmişti (Jo, 2026a; Li vd., 2026); bir sonraki deneyin eklediği husus ise bu tür düzeltmelerin farklı sorular ve modeller arasında da geçerli olup olmadığıdır.
Bir soruda işe yarayan bir prompt, başka bir soruda genellikle başarısız oldu
Daha sonra altı istem koşulunu üç başarısızlık türüyle karşılaştırdık: örtük kısıtlamaların göz ardı edilmesi (araba yıkama), boyut/uyum yargısı (kompakt bir arabada tam boy bir buzdolabını taşımak; bu örneği araba yıkama tarzında ele almıştık; bkz. Tang, 2026) ve halk inanışlarının geçersiz kılınması (bir patatesin çorbadaki fazla tuzu giderdiği yönündeki etkisiz iddia). Claude Haiku 4.5 ve GPT-5.4-nano modellerinin her biri hücre başına 20 çağrı alırken, GPT-4o-mini altı istem koşulundan beşinde 10 çağrı aldı (toplamda 870 çağrı; Şekil 3B, B’).
Haiku 4.5’te hedefin yeniden belirtilmesi araba yıkama performansını 0/20’den 20/20’ye çıkardı, ancak çorba örneğinde sonuç 0/20 olarak kaldı. “Peki, işin püf noktası ne?” sorusu çorba örneğinde performansı 19/20’ye yükseltse de araba yıkama örneğinde sadece 3/20’ye ulaştı. GPT-5.4-nano’da ise hedef istemi araba yıkama örneğinde 0/20, buzdolabı örneğinde 20/20 ve çorba örneğinde 3/20 sonuç verdi; “püf noktası” istemi ise sırasıyla 0/20, 20/20 ve 10/20 sonuçlar doğurdu. Bir öz-denetim istemi nano modelinin çorba örneğindeki sonucunu 0/20’de tuttu; bu, çıplak karşılaştırma olan 4/20 ile kıyaslandığında, bu hücre boyutunda bir zararı kanıtlamak için çok küçük bir farktı. Ancak içsel öz-düzeltme mekanizmaları başka alanlarda doğruluğu düşürmüştü (Huang ve diğerleri, 2024). Görünüşte istikrarlı olan buzdolabı sonucu bile aktarılamadı: hedefin yeniden belirtilmesi GPT-4o-mini’de 1/10’luk bir sonuç verdi.
Bu nedenle altı istem de genel olarak etkili ya da etkisiz olarak nitelendirilemez. Örneklenen bu hücreler genelinde, aynı istem modele ve soruya bağlı olarak daha yüksek, değişmemiş veya daha düşük başarı oranlarıyla ilişkilendirildi.
İki sistem tüm denemeleri geçti; diğerleri farklı ayrıntıları kaçırdı
Haziran 2026’da gerçekleştirilen test, dokuz görevi, dokuz OpenAI modelini ve dört Anthropic modelini kapsadı; her hücrede 10 çağrı yapıldı (toplam 1.170 çağrı; Şekil 3A). OpenAI modelleri üretim API’si üzerinden, Anthropic modelleri ise minimal bir başsız komut satırı ayarıyla çalıştırıldı; bu nedenle sağlayıcılar arası farklılıklar tanımlayıcı nitelikte olup kontrollü bir sıralama teşkil etmemektedir. Üç görev, sorunun vurgulamadığı bir öncülün kullanılmasını gerektirdi: araba yıkama; bizim oluşturduğumuz imkansız analog saat konfigürasyonu; ve yumurtanın beton zemine “çatlatmadan” düşürülmesiyle ilgili bilinen bilmece, burada zeminin çatlamaması gerekiyordu. Altı bilinen yanıltıcı soru kontrol görevi olarak kullanıldı ve modellerin çoğu bunları doğru yanıtladı: ayna ters çevirme (Block, 1974), beş kez tura gelmiş bir parayı takip eden soru (Tversky ve Kahneman, 1971), bir pound tuğla ile bir pound tüy karşılaştırması (Wagman ve diğerleri, 2007), güneye doğru yürüyen avcı (Gardner için zaten eski bir bilmeceydi, 1988) ve iki halk bilmece (asansör ve otobüs şoförü).
İki sistem, OpenAI API’sindeki GPT-5.5 ve minimal başsız Anthropic komut satırı ayarındaki Fable 5, arşivlenmiş 90 çalışmanın tamamını başarıyla tamamladı. Opus 4.8 (Anthropic, San Francisco, CA, Amerika Birleşik Devletleri) 88/90, o3 ve Sonnet 4.6 (Anthropic, San Francisco, CA, Amerika Birleşik Devletleri) 87/90, GPT-5 ise 82/90 başarı oranına ulaştı. Daha küçük modeller her alanda basitçe daha kötü değildi. Haiku 4.5 genel olarak 67/90 başarı oranına ulaştı; bu orana saatle ilgili görevlerin yarısı da dahildi ve bu, GPT-5 veya GPT-5.4’ten (her biri 2/10) daha fazlaydı. Ayrıca yumurtayla ilgili tüm görevleri tamamladı; GPT-4o bu görevlerde 6/10, GPT-5.4-mini ise hiç başarılı olamadı. Ancak Haiku 4.5 araba yıkama görevini asla geçemedi. GPT-5 tüm araba yıkama ve yumurta görevlerini tamamladı, fakat saatle ilgili görevlerde yalnızca 2/10 başarı oranına ulaştı. GPT-5.4-nano ise genel olarak 41/90 başarı oranına ulaşsa da üç ayırt edici görevin hiçbirini tamamlayamadı.
Bir hücredeki on başarılı deneme, yine de başarı oranı için geniş bir %95 Clopper–Pearson aralığı (yaklaşık %69–%100) anlamına gelmektedir. Araba yıkama sorusu Haziran ayındaki ölçümlerden önce kamuoyuna açık olduğundan, daha önceki maruz kalma durumu sonraki başarıların bir parçası olabilir. En iyi iki sistem, bu sınırlı ve kısmen kamuya açık test setini geçti; ancak bu sonuç, yeni varyasyonlarda nasıl performans göstereceklerini kanıtlamaz.
Bazı modeller sorduğumuz soru yerine bilindik bir soruyu yanıtladı
Ana bataryadan sonra dört ardışık keşif sondası turu geliştirdik (toplamda 360 çağrı). Bu sondalar önceden kaydedilmiş doğrulama çalışmaları değil, gösterim niteliğindedir ve yöntem bize ait değildir. Değiştirilmiş tanıdık bulmacalar üzerine yapılan toplama ve çalışmalar, modellerin genellikle hatırlanan versiyona göre yanıt verdiğini zaten göstermişti (cpldcpu, 2024; Huckle ve Williams, 2025; Mukhopadhyay vd., 2025; Fascendini vd., 2026); bu durum, karşıolgusal görev değerlendirmeleri için de genel olarak geçerliydi (Wu vd., 2024; McCoy vd., 2024; Mirzadeh vd., 2025). Tıpkı onlar gibi, her bir sondada da tanıdık bir problem öyle bir değiştirildi ki, meşhur cevabı hatırlamak artık yanlış bir sonuç verecekti.
Örneğin, dil modellerinin daha önce de incelendiği bilişsel yansıtma testindeki sopalar ve top problemi (Frederick, 2005) üzerinde değişiklik yaptık (Hagendorff vd., 2023): “Bir sopa ve bir top toplamda 1,10 dolar tutuyor. Sopanın fiyatı 1,00 dolar. Topun fiyatı ne kadar?” Meşhur versiyonun aksine, bu soruda sopanın fiyatının 1,00 dolar olduğu, topun fiyatından 1,00 dolar daha fazla olduğu söylenmiyor; dolayısıyla cevap 10 senttir. Fable 5, 20/20 denemede 10 sent cevabını verdi. Opus 4.8 ise 16.000 tokenlik akıl yürütme bütçesine rağmen eksik olan “daha fazla” ilişkisini aktararak 15/20 denemede beş sent cevabını verdi. Haiku 4.5 ise 20/20 denemede 10 sent cevabını verdi. Sadece bu son sonuç, dikkatli okumayı klasik probleme aşinalık olmamasından ayırt edemez; orijinal ve değiştirilmiş formları karşılaştırmak daha bilgilendiricidir.
Bir cümlenin astronomik bir imkansızlığı değiştirdiği durumlarda ve açık bir aile ilişkisinin tanıdık cerrah bilmecesini (Belle vd., 2021) değiştirdiği durumlarda da benzer hatalar tespit ettik; bu bilmecenin bir varyasyonu daha önce dil modellerine de sunulmuştu (Syksy, 2025). Bu keşif örneklerinde, bazı yanıtlar sunulan versiyon yerine tanıdık versiyonla eşleşti, hatta uzun süreli akıl yürütme sırasında bile. Açık bir yerel tanımlamaya rağmen önceden eğitilmiş okuma anlayışına geri dönme durumu sistematik olarak ölçülmüştür (Thota vd., 2026).
Aynı modeller yazılım ayarları arasında da değişti
Yazılım ayarı karşılaştırması 800 yanıt göstermektedir: aracı-kullanım pilotunun dört görevlik alt kümesinden 160, üç kontrol koşulundan 480 ve ana deneyde zaten sayılmış olan minimal-olusuz koşullardan 160 yanıt (Şekil 1). Fable 5, hem minimal olusuz ayarında hem de aracı kullanımında 40/40 puan aldı. Opus 4.8, 38/40’dan 29/40’a düştü; Sonnet 4.6, 37/40’tan 20/40’a; Haiku 4.5 ise 17/40’tan 12/40’a geriledi. Aracı çalışma alanı belleği, araba yıkama ve saat görevlerinin adını bile doğru belirtti, ancak Sonnet 4.6 bu ayarda hiçbirini geçemedi (her biri 0/10; buna karşılık olusuz koşullarda 9/10 ve 8/10 puan almıştı). Olusuz çalışmalara alakasız bellek, görevle ilgili bellek veya aracı rolü çerçevesi eklenmesi, hiçbir modelin toplam puanını 40 üzerinden 3’ten fazla düşürmedi; dolayısıyla bu ek metinler aradaki farkın çok azını yeniden üretti.
Ayarlar rastgele belirlenmemişti ve birkaç açıdan farklılık gösteriyordu; bu nedenle karşılaştırma, değişikliklere neyin neden olduğunu açıklayamaz. Ancak bir modelin hangi yazılım ayarında çalıştırıldığının bir değerlendirmede neden belirtilmesi gerektiğini göstermektedir. Rastgele ayarlı bir deney henüz yapılmamıştır; dikkat dağıtma ve uzun bağlamlar üzerine yapılan önceki çalışmalar olası mekanizmaları öne sürse de burada spesifik bir mekanizmayı doğrulamamaktadır (Shi ve diğerleri, 2023; Liu ve diğerleri, 2024). Özellikle araba yıkama maddesinde, tek başına başarılı olan yapılandırılmış bir istem, uzun bir üretim istemi içine yerleştirildiğinde etkisinin büyük bir kısmını kaybetti (Jo, 2026b); bu örüntü, aracı kullanım sonucuyla tutarlı olmakla birlikte, bu sonuçla kanıtlanmamıştır.
Çalışma 1: Katılımcılar insan yapımı ürünler için daha fazla ödeme yapacaklarını belirtti
Çalışma 1, Prolific platformundan 1.198 Amerikalı katılımcıyı, altı ürün kategorisinin bir isimli zanaatkar, genel bir insan işçi veya bir yapay zeka sistemi tarafından yapıldığını belirten etiketlere rastgele atadı. Kamuoyuna açık OSF kaydı, veri toplanmadan önce yapılmıştı. Bu kayıttaki dışlamalar ve WTP işleme sonucunda N = 1.006 katılımcı elde edildi (insan 292, zanaatkar 330, yapay zeka 384). Koşul hatırlama hataları, yapay zeka koşuluna kıyasla iki insan koşulunda daha sık görüldü; bu nedenle kayıt, bu katılımcıları da analizde tutacak bir tahmin gerektirmektedir.
Önceden kaydedilmiş insan-YZ tahmini güçlü bir şekilde desteklendi. Referans fiyata göre normalize edilmiş ortalama WTP, genel-insan etiketi altında 1.003, YZ etiketi altında ise 0.493 olarak bulundu: bu, %103.2’lik bir oran primi ve 0.509’luk normalize edilmiş ortalama fark anlamına geliyordu [%95 GA (0.454, 0.565)], Welch t(514.9) = 18.06, p < 0.001, d = 1.46 (Şekil 4A). Ürün düzeyindeki primler ekmek için %42.7’den resim için %218.1’e kadar değişti ve Holm ile düzeltilmiş altı p değerinin tamamı < 0.001 oldu. Koşul-hatırlama kontrolünü geçemeyen katılımcıların da dahil edilmesiyle N = 1, 180 ve %91.2’lik bir prim elde edildi. Ham, sınırsız WTP (+%121.7) ve referans fiyattan 10 kat daha yüksek herhangi bir yanıt veren tüm katılımcıların dışlanması (N = 983, +%102.5) aynı sonuca yol açtı. 18 koşul-ürün hücresinin tamamı p < 0.01 düzeyinde normaliteyi reddetti; kaydedilen Mann–Whitney analizleri de altı insan-YZ karşılaştırmasını destekledi.
Geriye kalan dört önceden kaydedilmiş test desteklenmedi ve her bir sonuç primin anlamını daralttı. Zanaatkar WTP genel olarak genel-insan WTP’den %9.9 daha düşüktü, t(611.5) = −3.03, tahmin edilen yön p = 0.999, d = −0.24 ve her ürün için daha düşüktü (Şekil 4A): insan primi, adı belirtilmiş bir yaratıcı gerektirmiyordu. Ayrıca, zanaatkar-YZ priminin genel-insan payının fonksiyonel/deneyimsel ürünlerde yaratıcı/simgesel ürünlere göre daha yüksek olacağını tahmin etmiştik; ancak fark tersine döndü (ortalama fark −0.239, tam tahmin edilen yön permütasyon p = 0.95). Beklenen kalite sabit kalmadı: insan etiketi altı ürünün tamamında kaliteyi artırdı (tüm Holm p < 0.001; tüm Bayes faktörleri güçlü bir şekilde bir farkı destekledi). Zanaatkar ve genel-insan kalitesi benzerdi (tüm Holm p≥0.71 ve tüm BF01>3.3). Son olarak, YZ-etiketi WTP varyansı hiçbir ürün için en yüksek değildi.
İnsan etiketi, beyan edilen WTP üzerinde büyük ve sağlam bir etkiye sahipti. Çalışma, bu etkinin beklenen kaliteden bağımsız olduğunu göstermedi ve herhangi bir zanaatkar primi bulamadı.
Çalışma 2: Aktif yargılama, daha geniş bir insan-üretimi karşılaştırması içinde bir prim taşıdı
Çalışma 2’de yeni bir Prolific örneklemi üç üretim senaryosuna rastgele atandı: aktif yargılama ve ayarlamalar yapan bir insan, yaratıcı yargı içermeyen standartlaştırılmış prosedürleri izleyen bir insan veya insan müdahalesi olmayan bir yapay zeka sistemi. AsPredicted kaydı veri toplama öncesinde gerçekleştirildi. Dışlama kriterleri sonucunda N = 589 katılımcı elde edildi (aktif yargılama: 214, standartlaştırılmış insan: 180, yapay zeka: 195).
Ortalaması normalleştirilmiş WTP, aktif yargılama koşulunda 0,996, standartlaştırılmış insan koşulunda 0,824 ve yapay zeka koşulunda 0,536 olarak bulundu (Şekil 4B). Aktif yargılama tanımı, beyan edilen WTP’yi standartlaştırılmış insan tanımına kıyasla %20,9 oranında artırdı. Normalleştirilmiş ortalama fark 0,172 [%95 GA (0,091, 0,254)], t(387,5) = 4,16, çift yönlü p < 0,001, d = 0,41 idi. Standartlaştırılmış insan tanımı, WTP’yi yapay zeka tanımına göre %53,8 oranında artırdı: fark 0,288 [%95 GA (0,215, 0,361)], t(372,1) = 7,79, p < 0,001, d = 0,80. Aktif yargılama içeren insan tanımı, yapay zeka tanımından %86,0 daha yüksekti (d = 1,09). Aktif yargılama ve yapay zeka tanımları arasındaki 0,460’lık normalleştirilmiş birimlik farkın 0,288’i (yaklaşık beşte üçü), yaratıcı yargı belirtmeyen standartlaştırılmış insan tanımını yapay zeka tanımından ayırıyordu.
Ürün düzeyindeki karşılaştırma, önceden kaydedilmiş tahminimizin tersine sonuç verdi. Aktif yargılama farkının, standartlaştırılmış insan-yapay zeka farkını aşmasını bekliyorduk; ancak altı ürün genelinde bu fark daha küçüktü: eşleştirilmiş t(5) = −3,87, çift yönlü p = 0,0117 (tahmin edilen yön p = 0,994; Şekil 4C). Aktif yargılama primleri, teşhis için %7,2’den resim yapma için %60,1’e kadar değişti. Standartlaştırılmış insan ile yapay zeka arasındaki primler ise %35,0 ile %77,1 arasında değişti.
Kayıt altına alınmış kategori düzeyindeki test, yaratıcı ürünlerde aktif yargılama priminin fonksiyonel ürünlere göre daha büyük olduğunu kanıtlayamadı: Welch t(2,02) = 2,59, çift yönlü p = 0,121. Katılımcı düzeyindeki yaratıcı-eşdeğer-fonksiyonel karşılaştırması anlamlıydı: t(389,5) = 3,04, p = 0,0025; ancak bu, kaydedilmiş bir test değildi ve keşif niteliğindedir.
Beklenen kalite, tanımlamalarla birlikte bir kez daha değişti. Keşif amaçlı, düzeltilmemiş Welch testlerinde, aktif yargı ve standartlaştırılmış insan tanımlamaları arasında resim, müzik ve makale için beklenen kalite açısından farklılıklar gözlemlendi (hepsi p < 0.001), ancak üç fonksiyonel ürün için bu farklılık görülmedi. Dolayısıyla, kaliteye ilişkin inançlar, aktif yargıdaki farkın bir kısmını açıklayabilir. Makale ise diğer tarafta betimsel bir istisna sunuyor: standartlaştırılmış insan ve yapay zeka tanımlamaları altında beklenen kalite neredeyse aynıydı (1–7 ölçeğinde 4.28’e karşı 4.33), ancak beyan edilen ödeme isteği (WTP) standartlaştırılmış insan için %40,5 daha yüksekti (Holm p = 0.009). Kalite açısından eşleştirilmiş bir karşılaştırmayı önceden kaydetmemiştik; bu durum, insan üretimiyle ilgili karşıtlığın bir kısmının beklenen kalite tarafından taşınmadığını göstermektedir.
Tartışma
Yapay zeka sonuçları, modellerin ya fark ettiğine ya da fark etmediğine dair basit bir iddiayı desteklememektedir. GPT-5.5 ve Fable 5, Haziran ayındaki test serisindeki tüm denemeleri geçmiştir. Diğer modeller farklı detayları gözden kaçırmış, aynı komut ise bir sorunu çözerken başka birini çözememiş olabilir. Bir model, bir soruda kilit bilgiyi kullanırken bir sonrakinde bunu göz ardı edebilir. Toplam skor faydalı olsa da, bir cevabı hangi detayların belirlediğini gizleyebilir.
Bazı başarısızlıklar tanıdık bir insani biçime sahipti. Opus 4.8, içinde “daha fazlasından” ifadesi geçmeyen bir sopalı-top sorusuna beş sentlik bir yanıt verdiğinde, kendisine sorulan soruya değil, beklediği soruya cevap vermişti. Langer’ın dikkatsizlik üzerine yaptığı ilk gösterimler, insanların da aynı şeyi yaptığını ortaya koymuştu: İnsanlar, bir gerekçenin tanıdık biçimini taşıyan ancak içeriği olmayan bir talebe uymuşlardı (Langer ve diğerleri, 1978); ayrıca, daha sonra alakasız göründüğünde eleştirel bir şekilde kabul etmedikleri bilgiler, söz konusu bilgi geçerli olduğunda performanslarını kısıtlamıştı (Chanowitz ve Langer, 1981). Biz gözlemlenebilir davranışta bir benzerlik iddia ediyoruz, ortak bir mekanizma değil. Bu benzerlik aynı zamanda çözümün sınırlarını da belirliyor. İnsanlarda, üç yeni unsuru fark etmeye yönelik kısa bir talimat, test edilen bilişsel önyargıların çoğunu azaltmıştı (Maymin ve Langer, 2021). Seçilen modellerde ise aynı talimat 100 denemede yalnızca beş başarılı geçiş sağladı; bu da tek cümlelik bir yanıt talebinden daha fazlası değildi. “Fark et” talimatının kendisi de başka bir senaryo olarak takip edilebilir. Varış noktasına fiziksel olarak neyin ulaşması gerektiğini sormak bazen hedef yanıtı ortaya çıkardı; ancak önceki çalışmalar bu soru için benzer sonuçları göstermişti (Jo, 2026a; Li ve diğerleri, 2026) ve görevlere göre yapılan uyarı deneyi, bu tür düzeltmelerin diğer sorulara veya modellere güvenilir bir şekilde genellenmediğini ortaya koydu.
Tüketici sonuçları tek bir dikkatli farkındalık primi göstermiyor. İnsanlar, insan üretimiyle ilgili tanımlamalar altında önemli ölçüde daha fazla ödeyeceklerini belirttiler; insan üreticinin aktif bir yargı kullandığı açıklandığında ise ödemeye istekli oldukları miktar daha da arttı. Yine de, Çalışma 2’deki aktif yargı kullanan insan ile yapay zeka arasındaki farkın yaklaşık beşte üçü, insan üreticinin hiçbir yaratıcı yargı kullanmadığı belirtildiğinde de devam etti. Aktif yargı değere katkıda bulundu, ancak katılımcıların insan üretimine atfettiği değerin tamamını oluşturmuyordu. Çalışma 1, bu değerin isimsiz bir zanaatkar gerektirmediğini ortaya koydu ve her iki çalışma da kalite algılarının tanımlamalara bağlı olarak değiştiğini gösterdi.
Daha önceki performans çalışmaları bu sonuçla iki yönden ilişkilidir. Bilinçli farkındalığı tetiklemek için tasarlanan talimatlar, bilgi sahibi olmayan katılımcıların duyduklarını veya gördüklerini değiştirmişti: Dinleyiciler daha incelikli orkestra kayıtlarını tercih ederken, değerlendiriciler aynı Rotary Kulübü metninden yola çıkarak çalışan kadınları daha samimi olarak nitelendirmiş ve soğuk sunum karşılaştırmalarında liderlikte artış gözlemlemişlerdi (Langer ve diğerleri, 2009; Kawakami ve diğerleri, 2000). Buna karşılık, tüketici katılımcılarımız yalnızca metinsel açıklamalarla karşılaştılar. Onlar, bilinçli bir çalışmanın ürün üzerinde bir iz bıraktığı inancını ödüllendirebilirlerdi, ancak aslında hiçbir ürünü görmediler.
Peki, katılımcılar daha geniş kapsamlı standartlaştırılmış insan-AI karşılaştırmasında tam olarak neye değer veriyorlardı? Olası nedenler arasında beklenen kalite, çabaya duyulan saygı, özgünlük, kimlik, sorumluluk, ahlaki endişe veya basitçe insani bir geçmişe sahip bir nesneye yönelik tercih yer alabilir (Kruger ve diğerleri, 2004; Newman ve Bloom, 2012; Fuchs ve diğerleri, 2015; Granulo ve diğerleri, 2021; Longoni ve Cian, 2022; Bellaiche ve diğerleri, 2023; Hu ve diğerleri, 2026). Beklenen kalitenin neredeyse eşit olduğu ancak belirtilen ödemeye istekliliğin öyle olmadığı makale, kaliteyle ilgili inançların tüm hikayeyi açıklamadığını göstermektedir. Açıklamalarımız bu ipuçlarını bir arada sunduğu için bu durum hâlâ bir yorum olarak kalmaktadır. Daha güçlü bir takip çalışması, üretici kökenini üretim süreciyle kesiştirebilir, tüm katılımcılara aynı sonucu gösterebilir ve gerçek satın alımları kullanabilirdi. Böyle bir tasarım, nesnenin kendisine yönelik bir tercihi, kalitesine dair bir inancı ve arkasındaki insani geçmişe yönelik bir tercihi birbirinden ayırabilirdi.
Kanıtların önemli sınırlamaları bulunmaktadır. İlk istem deneyinde beş model, daha önce bir soruyu yanıtlamada başarısız oldukları için seçilmişti; ancak arşivlerinde orijinal istem betiği, zaman damgaları, örnekleme ayarları ve sağlayıcı tarafından döndürülen model kimlikleri bulunmamaktadır. Minimal komut satırı ortamındaki Fable 5 tanımlaması, komut satırı takma adı ve modelin kendi beyanına dayanmaktadır. Değişen detay içeren çalışmalar ardışık olarak geliştirilmiş ve yazılım ayarları karşılaştırması rastgeleleştirilmemiştir. Model denetimlerinde, değerlendirilen bazı modellerle aynı ailelerden gelen değerlendiriciler kullanılmıştır: Bir Fable 5 örneği, Fable 5’in kendi yanıtları da dahil olmak üzere Anthropic yanıtlarını yeniden değerlendirmiş, GPT-5 tabanlı bir Codex ise OpenAI’nin kural kararlarını kontrol etmiştir. Tüketici örneklemeleri ABD’deki Prolific katılımcılarından toplanmış olup, onların WTP (ödeme isteği) raporları varsayımsal nitelikteydi ve ekranda gösterilen tipik bir fiyatın yanında yapılmıştı. İnsan emeği için daha yüksek bir fiyat belirtmek, kısmen katılımcıların ödemeye istekli oldukları bir fiyattan ziyade sergilemek istedikleri bir tutumu yansıtabilir.
Langer’ın anlamında farkındalık, aktif bir şekilde dikkat etmektir. Model deneyleri bunun bir davranışsal izini inceler: Bir yanıtın, ne yapılması gerektiğini değiştiren detayı kullanıp kullanmadığı. Tüketici deneyleri ise insanların insan emeği ve aktif yargıya ilişkin açıklamaları nasıl değerlendirdiğini inceler. Her iki program da yapay zekada bir zihinsel durumu kanıtlamaz, farkındalık için kesin bir fiyat belirlemez veya her iki bölümde de ortak bir mekanizmayı tespit etmez. Birlikte okunduklarında, başlangıçta belirttiğimiz iki iddiaya yanıt verirler. Bir modelin belirleyici detayı kullanıp kullanmaması modele, isteme ve ortama bağlıydı; mevcut en iyi sistemler ise sunduğumuz tüm maddeleri geçti. Katılımcılar, tanımlanan yargıya yaklaşık %21 oranında bir fiyat biçtiler; ancak insan emeğine atfettikleri değerin büyük bir kısmı, insanın hiçbir detay kullanmadığı belirtildiğinde de korunmuştur.
Bundan iki pratik sonuç çıkmaktadır. Yapay zeka değerlendirmeleri açısından tek bir başarı oranı yanlış ölçüttür. Değerlendiriciler, maddeler düzeyinde profiller sunmalı, her tanıdık soruyu doğru cevabı farklı olan değiştirilmiş bir versiyonuyla birlikte puanlamalı (Wu ve diğerleri, 2024; McCoy ve diğerleri, 2024) ve modelin bir ayarlarda başarılı olup başka bir ayarlarda başarısız olması durumunda kullanılan yazılım ayarını belirtmelidir. Dikkatli olmaya veya varsayımları fark etmeye yönelik genel talimatların bu hataları düzelteceği varsayılmamalıdır; hedefe ilişkin somut sorular bazen bu durumu düzeltebilir, ancak etkisinin yeni görevlerde de test edilmesi gerekir. İnsan emeğini savunan herkes için, makinelerin zayıflıkları fark edememesine dayanan bir argüman, her yeni modelle birlikte zayıflar; mevcut iki sistem bile sunduğumuz tüm maddelerde başarılı olmuştur. Katılımcılarımızın bu argümana ihtiyacı yoktu. Bildirdikleri ödemeye isteklilikleri, tanımlanmış yargı becerileri için bir prim içeriyordu ve bu prim, insan katılımcının hiçbir yaratıcı yargı kullanmadığı belirtilse bile yapay zekadan belirgin şekilde daha yüksekti. Bu anlamda, başlıktaki sezgi geçerliliğini koruyor: Zekâ ucuz olduğunda, insanlar yine de insan üretiminin bir değer biçiyor ve bu değerin yalnızca bir kısmı, onlara söylendiği gibi içerdiği yargı becerisine karşılık geliyor.
Beyanlar
Veri erişilebilirliği beyanı
Kamuya açık ön kayıtlar https://osf.io/rts67/ ve AsPredicted #279021 adreslerinden erişilebilir. Tanımları gizlenmiş analiz verileri, 4.240 çağrıdan oluşan tam model yanıtı derlemesi, kaynak hash’leri, satır düzeyindeki değerlendirme kayıtları, analiz betikleri, sabitlenmiş yazılım sürümleri ve makine tarafından okunabilir sonuçlar Ek Veriler bölümünde sunulmuştur. Tam zaman damgaları, oturum ve tamamlama kodları ile serbest metin tüketici yanıtları, yeniden üretme süreci için gereksiz oldukları için kamuya açık analiz tablosundan çıkarılmıştır.
Etik beyanı
İnsanları içeren çalışmalar Fairfield Üniversitesi IRB Başkanı [email protected] tarafından onaylanmıştır. Çalışmalar yerel mevzuata ve kurumsal gerekliliklere uygun olarak yürütülmüştür. Katılımcılar bu çalışmaya katılmak için yazılı ve bilgilendirilmiş onaylarını vermişlerdir.
Yazar katkıları
EL: Kavramlaştırma, Metodoloji, Denetim, Yazım – inceleme ve düzenleme. PM: Kavramlaştırma, Veri kürasyonu, Formal analiz, Araştırma, Metodoloji, Yazılım, Görselleştirme, Yazım – orijinal taslak, Yazım – inceleme ve düzenleme.
Çıkar çatışması
Yazar(lar), bu çalışmanın potansiyel bir çıkar çatışması olarak yorumlanabilecek herhangi bir ticari veya finansal ilişki olmaksızın yürütüldüğünü beyan etmiştir.
Üretken yapay zeka beyanı
Yazar(lar), bu makalenin oluşturulmasında üretken yapay zekanın kullanıldığını beyan etmiştir. Yazar(lar), bu makalenin hazırlanmasında üretken yapay zekanın kullanımını kabul etmektedir. Anthropic Claude Opus 4 ailesi sistemleri (Anthropic; hayatta kalan kayıtlarda tam uç nokta ve istemci sürümü korunmamıştır), orijinal makalenin analiz betiklemesine, şekil oluşturmaya ve metin düzenlemesine yardımcı olmuştur. Ağustos ve Eylül 2026’da Codex CLI 0.144.1 ve 0.153.2 (OpenAI) aracılığıyla erişilen GPT-5 tabanlı OpenAI Codex; dosya denetimi, tekrarlanabilirlik kodu, yeniden hesaplama, taslak hazırlama, literatür kontrolü, yanıt mektubu hazırlama, makale ve PDF denetimleri ile Malzemeler ve yöntemler bölümünde açıklanan kör olmayan kural-sınıflandırıcı denetimine yardımcı olmuştur. 21 Ağustos 2026’da Claude Code 2.1.238 (Anthropic) aracılığıyla erişilen Claude Fable 5, Malzemeler ve yöntemler bölümünde açıklanan karşıt görüşlü ikinci değerlendirme incelemelerini ve körlemesine yeniden notlandırmayı sağlamıştır. Codex CLI 0.153.2 (OpenAI) aracılığıyla erişilen OpenAI GPT-6 Astra ve Claude Code 2.1.278 (Anthropic) aracılığıyla erişilen Claude Fable 5.1, 21–22 Eylül 2026’da bağımsız geliştirme düzenlemeleri yapmıştır. 27 Eylül 2026’da Claude Code 2.1.283 (Anthropic) aracılığıyla erişilen Claude Opus 5.5, yanıt mektubu yerlerini kontrol etmiş, ödünç alınan test öğelerinin ve istemlerin kökenini atıf için izlemiş ve son revizyonların taslağını hazırlamıştır. Yazar(lar), model destekli tüm içeriği verilerle, yürütülebilir analizlerle, makale kaynaklarıyla ve alıntılanan literatürle karşılaştırmış ve her bir iddia ile karardan sorumlu olmaya devam etmektedir.
Bu makaledeki şekillerin yanında yer alan tüm alternatif metinler (alt metinler) Frontiers tarafından yapay zeka desteğiyle oluşturulmuş olup, doğruluğu sağlamak için makul çabalar sarf edilmiş ve mümkün olduğunda yazarlar tarafından incelenmiştir. Herhangi bir sorun tespit ederseniz lütfen bizimle iletişime geçin.
Yayıncının notu
Bu makalede ifade edilen tüm iddialar yalnızca yazarlara aittir ve yazarların bağlı olduğu kuruluşların, yayıncının, editörlerin veya hakemlerin görüşlerini yansıtmak zorunda değildir. Bu makalede değerlendirilebilecek herhangi bir ürün veya üreticisi tarafından yapılabilecek herhangi bir iddia, yayıncı tarafından garanti edilmez veya onaylanmaz.
Ek materyaller
Bu makalenin Ek Materyallerine çevrimiçi olarak şu adresten ulaşılabilir: https://www.frontiersin.org/articles/10.3389/frai.2026.1914761/full#supplementary-material
Özet
Anahtar kelimeler
aktif farkındalık, insan üretimi, büyük dil modelleri, farkındalık, önceden kayıt, istem duyarlılığı, ödeme isteği
Atıf
Langer EJ ve Maymin PZ (2026) Zekâ ucuz olduğunda, farkındalık paha biçilmezdir: Yapay zeka performansı ve insan üretiminin değeri. Front. Artif. Intell. 9:1914761. doi: 10.3389/frai.2026.1914761
Alındı
20 Haziran 2026
Revize edildi
27 Eylül 2026
Kabul edildi
26 Ekim 2026
Yayınlandı
16 Kasım 2026
Cilt
9 – 2026
Xi Chen, Yunnan Üniversitesi, Çin
Sai Gattupalli, Toplum ve Yapay Zeka Araştırma Grubu, Amerika Birleşik Devletleri
Miles Yang, Macquarie Üniversitesi, Avustralya
© 2026 Langer ve Maymin.
Bu, Creative Commons Atıf Lisansı (CC BY) şartları altında dağıtılan açık erişimli bir makaledir. Orijinal yazarların ve telif hakkı sahiplerinin belirtilmesi ve bu dergideki orijinal yayına kabul edilen akademik uygulamalara uygun olarak atıfta bulunulması koşuluyla, diğer platformlarda kullanılması, dağıtılması veya çoğaltılmasına izin verilir. Bu şartlara uymayan hiçbir kullanım, dağıtım veya çoğaltmaya izin verilmez.
*Yazışma: Philip Z. Maymin, [email protected]
†
ORCID: Philip Z. Maymin orcid.org/0000-0002-3926-8720
Bu makalede ifade edilen tüm iddialar yalnızca yazarlara aittir ve yazarların bağlı olduğu kuruluşların, yayıncının, editörlerin veya hakemlerin görüşlerini yansıtmak zorunda değildir. Bu makalede değerlendirilebilecek herhangi bir ürün veya üreticisi tarafından yapılabilecek herhangi bir iddia, yayıncı tarafından garanti edilmez veya onaylanmaz.
Yorumlar