Konuşma Arayüzü Olan Yordamcı Bakım Sistemi: Frontiers’dan Yeni Çalışma
1. Bilgisayar ve Elektrik Mühendisliği Bölümü, Amrita Bilgisayar Okulu, Amrita Vishwa Vidyapeetham, Chennai, Tamil Nadu, Hindistan 2. Siber Güvenlik…
ORİJİNAL ARAŞTIRMA MAKALESİ
Front. Artif. Intell., 11 Kasım 2026
Bölüm: Yapay Zeka İşletmelerde
Cilt 9 – 2026 | https://doi.org/10.3389/frai.2026.1930680
- SS
Suthir Sriram 1
- NV
Nivethitha Vijayaraj 1*
- HB
Hasini Balabommu 1
- GC
Gaurav Choudhary 2
-
1. Bilgisayar ve Elektrik Mühendisliği Bölümü, Amrita Bilgisayar Okulu, Amrita Vishwa Vidyapeetham, Chennai, Tamil Nadu, Hindistan
-
2. Siber Güvenlik Mühendisliği Bölümü, DTU Compute, Danimarka Teknik Üniversitesi (DTU), Kongens Lyngby, Danimarka
Makale metrikleri
Özet
Giriş:
Tahmine dayalı bakım (PdM), ekipman arızalarını geçmiş bakım verilerinden tahmin ederek, termik elektrik santrallerinde yaygın olan reaktif ve planlı bakımın sınırlamalarını aşmaktadır. Bu çalışma, özel sensör altyapısı olmadan yalnızca kurumsal bakım kayıtlarının ekipman riski tahminini destekleyip destekleyemeyeceğini incelemektedir ve tahminleyiciyi çevrimdışı bir sohbet asistanıyla birleştirir.
Yöntemler:
2014–2026 yılları arasında tek bir termik elektrik santralinden 8.943 SAP Bitki Bakım kaydını kullandık. Temizlik ve bir sonraki arıza zamanına dayalı etiket türetme işlemlerinden sonra 6.846 kayıt kaldı; bu kayıtlar 447 izlenen ekipman parçasının 388’ini ve 391 işlevsel konumun tamamını kapsamaktadır. Rastgele Orman sınıflandırıcısı, tek bir kronolojik 80/20 eğitim-test bölünmesiyle her ekipman parçasını YÜKSEK/ORTA/DÜŞÜK risk kategorisine atadı ve ayarlamalar için zaman serisi çapraz doğrulama uygulandı. Performans, McNemar testi ve bootstrap güven aralığı kullanılarak çoğunluk sınıfı temel çizgisiyle karşılaştırıldı. Sorgu niyetine göre yönlendirilen, 40 soruluk bir set üzerinde değerlendirilen çevrimdışı bir Llama 3.2 asistanı (Ollama üzerinden) test edildi.
Sonuçlar:
Sınıflandırıcı, 57.08% test doğruluğu elde etti ve bu değer, istatistiksel olarak ayırt edilemeyen bir 57.01% çoğunluk sınıfı temelinden (McNemar testi, p = 1.00; bootstrap 95% güven aralığı, [−1.90, 2.04] yüzde puanı) farklı değildi. Yapılan azaltma çalışması, fonksiyonel konum dahil edildiğinde ekipman kimliğinin ölçülebilir bir doğruluk katkısı sağlamadığını gösterdi. Zemin verisi bulunamadığında yanıtları uydurmak yerine açıkça yanıt vermeyi reddeden niyet yönlendirmeli mimaride, 40 sorudan 55’i doğrulanabilir şekilde güvenilir yanıtlar üretirken, orijinal yaklaşımda tahmini olarak %25–30 seviyesindeydi.
Tartışma:
Mevcut SAP meta verisinin çoğunluk sınıfını tahmin etmekten istatistiksel olarak algılanabilir bir iyileştirme sağlamadığı görüldü; dolayısıyla ERP meta verisinin yalnızca sınırlı ve istatistiksel olarak onaylanmamış bir tahmin sinyali sunduğu ortaya çıktı. Çerçevenin katkısı büyük ölçüde mimari niteliktedir: yeni kayıtlar geldikçe doğru şekilde etiketleri yeniden türeten bir yeniden eğitim boru hattı, rol bazlı erişim kontrolü ve bir çevrimdışı asistan. Sonuçlar, büyük dil modellerinin zeminlendirilmesinin anahtar kelime tetiklemeli sorgulama yerine niyet farkındalıklı geri bildirim gerektirdiğini gösteriyor.
1 Giriş
Termik santrallerde ekipman arızaları büyük bir rahatsızlık yaratır: elektrik üretimini durdurur, güvenlik riski oluşturur ve milyonlarca dolarlık kayıplara yol açar. Sektör tahminlerine göre ekipman duraklamaları nedeniyle verimlilik kayıpları %5 ile %20 arasında değişmekte, bakım giderleri ise her yıl milyonlarca dolara ulaşmaktadır (Mobley, 2002). Termik santraller, elektrik verimini verimli biçimde üretmek için sürekli çalışması gereken soğutma kuleleri, pompalar, vanalar, motorlar, türbinler ve yüzlerce başka bileşenden oluşur. Güncel uygulamada iki bakım stratejisi baskındır: ekipmanın arızalanmasından sonra yalnızca onarım yapılan reaktif bakım ve belirli bir zaman diliminde bileşenlerin değiştirilen önleyici bakım. İkisi de kusurludur: birincisi planlanmamış arızalara yol açarken, ikincisi gereksiz bakım maliyeti yaratır. Makine öğrenmesi, zaman içinde bozulma desenlerini tespit etmek için geçmiş ekipman durumu ve bakım verilerini analiz ederek arızaları gerçekleşmeden önceden öngörmeyi sağlar ve böylece bakım proaktif biçimde planlanabilir (Motaghare ve ark., 2018). Reaktif ve önleyici bakımın sınırlamalarını gidermek amacıyla, ek sensör ekipmanı gerektirmeden yalnızca mevcut SAP Bitki Bakım kayıtlarına dayanan yapay zeka tabanlı bir tahmine dayalı bakım sistemi öneriyoruz. Tahmin yeteneğinin yanı sıra önerilen sistem, mühendislerin teknik geçmişlerinden bağımsız biçimde erişilebilir olmasını sağlamak amacıyla İngilizce ile bir yapay zeka asistanıyla iletişim kurmayı da destekler. Sistem, her erişimde tüm 447 adet ekipmanın risk durumunu kontrol eder ve bakım personeline olası gelecekteki arızaları bildirir (Bölüm 3.4 bu erişim tetiklemeli tasarımı ele alır ve zamanlanmış arka plan kontrolünü gelecekteki çalışmalar olarak belirler), ayrıca yeni bakım ve ekipman verileri elde edildikçe tahmine dayalı modelin yeniden eğitilmesini destekler.
2 Literatür taraması
2.1 Tahmine dayalı bakımda makine öğrenmesi
Ensemble tabanlı yaklaşımlar, endüstriyel tahmine dayalı bakım ortamlarında sürekli olarak etkili olmuştur. Ran ve arkadaşlarının (2019) kapsamlı sistematik incelemesi, Random Forest’ın en sık benimsenen algoritmalar arasında olduğunu bulmuştur; gürültülü girişlere karşı dayanıklılığı, kategorik değişkenler için yerleşik destek ve özellik önem derecelerinin yorumlanabilirliği gibi avantajları, ensemble öğrenmenin güçlü yönleriyle doğal bir uyum sağlar ve bu nokta, veriye dayalı tahmine dayalı bakım yöntemlerine dair bir ankette de vurgulanmıştır (Zhang ve arkadaşları, 2019). Ensemble yöntemlerinin bu geniş literatürde baskın olmaları, endüstriyel arıza tahmininin problem yapısının—heterojen veri, sınıf dengesizliği ve gürültülü sinyaller—ensemble öğrenmenin güçlü yönleriyle doğal bir uyum içinde olduğunu göstermektedir. Duruma dayalı bakım konusundaki birkaç teorik bakış açısı bulunmaktadır: kavramsal bir incelemede Jardine ve arkadaşları (2006), duruma dayalı bakım modellerini fizik tabanlı, bilgi tabanlı ve veriye dayalı olmak üzere üç sınıfa ayırmıştır; bu sınıflandırma, daha sonraki döner makine tahmin ve sağlık yönetimi tasarım incelemelerinde de yankılanmıştır (Lee ve arkadaşları, 2014). Temel argümanları, fizik tabanlı modellerın endüstriyel düzeyde nadir ya da maliyetli olduğu ortamlarda, veriye dayalı modellerın en pratik yol olduğunu savunmaktır—ki bu da mevcut araştırmanın ele aldığı durumla tam olarak örtüşmektedir: bol miktarda tarihsel veri, ancak fizik modeli yok. Bu iddiayı daha da güçlendiren Kolokas ve arkadaşları (2018), hem arızanın olasılığını hem de türünü tespit edebilen gerçek zamanlı bir tahmin sistemi raporlamış ve birkaç endüstriyel ortamda yürütülen vaka çalışmalarını, sınıflandırma tabanlı makine öğrenmesi modellerinin genellenebilirliğini desteklemektedir. Zaman serisi yöntemleri de önemli ilgi çekmiştir: kalıntı kullanım ömrü (KÜÖ) tahmini için derin dolanıklı sinir ağları (CNN) önerilmiştir (Li ve arkadaşları, 2018; Zhao ve arkadaşları, 2019), uzun kısa süreli hafıza (LSTM) ağları son yıllardaki diziler tabanlı bakım modellerının temelini oluşturmuştur (Hochreiter ve Schmidhuber, 1997) ve KÜÖ tahmini için uçtan uça bir özellik dikkat mekanizması da tanıtılmıştır (Liu ve arkadaşları, 2021). Yapay zekanın daha erken ve iyi kabul görmüş bir özeti de…
Makine öğrenimine dayalı tahmine dayalı bakımı için gerekli zihinsel altyapının büyük kısmını Pham ve Pham (1999) sağlıyor.
2.2 SAP tesis bakım veri analitiği
# Öngörücü Bakım Sistemi için Sohbet Arayüzü
Bakım işleyişini iş dünyası açısından ele alırken sıkça dile getirilen bir soru şudur: Ad-hoc sensör verisi bulunmayan durumlarda, bakım ERP sistemine kaydedilmiş geçmiş iş emirleri proaktif bakım için yeterli bir sinyal sağlayacak düzeyde mi? Bousdekis ve arkadaşları (2015), durum temelli bakımdaki karar verme süreçlerini inceleyerek tanı ve tahmini, bakım kararlarından ayıran bir çerçeve önerir; bu çerçevede gelecekteki arızaları öngören tahminlerle tetiklenen proaktif öneriler yer alır. Çerçeve gerçek zamanlı sensör verisi varsayımına dayanmakla birlikte, tahmini karar desteğinden ayırma yaklaşımı, mevcut sistemin uyarı katmanını biçimlendiren ve burada benimsenen genel yaklaşımı doğrudan doğrulayan bir temel sunar. Kans ve Ingwald (2008), bakım kayıtlarını ortak bir veritabanında diğer operasyonel verilerle birleştirmenin bakım performansının maliyet etkin biçimde iyileştirilmesini desteklediğini savunur. Bakım kayıtlarını yalnızca idari bir belge olarak değil, bir analiz kaynağı olarak ele almak, bu çalışmadaki özellik seçimini yönlendiren bir örneği kurar. Zaman serili operasyonel günlüklerden durumla ilgili göstergeleri çıkarmak, yalnızca SAP tabanlı işlemlere özgü değildir; makine tahmini üzerine bir dizi yayında, makine aşınmasını öngören özelliklerin çıkarılması ve bir araya getirilmesi yöntemleri (Lei ve arkadaşları, 2018; Salunkhe ve arkadaşları, 2018; Medjaher ve arkadaşları, 2012) gösterilmiştir. Sensör tabanlı yöntemler ve yaygın bir temel için Nectoux ve arkadaşları (2012)’ye bakılabilir; rüzgar türbini popülasyonlarına uygulanan operasyonel meta veriler için ise Canizo ve arkadaşları (2017)’ye bakılabilir. Bu çalışma bir bütün olarak, SAP bildirim kayıtlarını ekipman arızasının güvenilir bir proxy’si olarak ele alır; bu makale de bu varsayımı doğrudan gerekçelendirilmeden benimsemiştir. Bu varsayım otomatik olarak güvenli değildir: SAP bildirimleri, altta yatan olaya göre gecikmeyle girilebilir, gerçek bir arızadan ziyade küçük bir kusuru kaydedebilir ve çok yıllı bir pencere içinde teknisyenler arası tutarsız kodlama, bakım politikasında ya da SAP sınıflandırmasında değişiklikler, ayrıca varlıklar içinde ekipman değiştirme veya yeniden numaralandırma gibi etkenlerle etkilenir.
2.3 Sanayi uygulamaları için büyük dil modelleri
Kayıtlara yansımayan başarısızlıklar da olabilir. Bölüm 3.5’te benimsenen kronolojik ayrım, bu durumu somut bir biçimde ortaya koyan bir belirti sunar: eğitim döneminde yüksek riskli durumlar %43,9 iken test dönemininde bu oran %57,0’a ulaşır. Bu fark, zaman içinde bildirim veya bakım davranışlarında bir değişimle uyumludur ve başarısızlık sürecinin durağan olduğunu göstermez. Bu nedenle ERP bildirim geçmişini doğru bilgi olarak kabul etmek, bu çalışmanın bir çalışma varsayımıdır ve kesin bir gerçektir. Gelecek çalışmalar, mümkün olduğunda bağımsız bakım kayıtlarıyla bildirim zaman damgalarını ve kategorilerini açıkça doğrulamalıdır.
Küçük, yerel LLM dağıtımlarının giderek artan erişilebilirliği, sınırlı kaynaklı endüstriyel bağlamlarda konuşmalı yapay zekanın giderek daha uygulanabilir olmasını sağladı. Örneğin Touvron ve arkadaşları (2023), daha küçük, açık ağırlıklı LLM’lerin özel alan görevlerinde daha büyük modellerle eşleşebildiğini göstererek, bulut erişiminin kısıtlı olduğu veya güvenlik nedeniyle harici API kullanımının yasaklandığı ortamlarda çevrimdışı dağıtımı mümkün kıldıklarını ortaya koydular. LLM’lerin çeşitli görevlerdeki esnekliği, Brown ve arkadaşları (2020) tarafından da gösterildi: LLM’lerin soru-cevap için minimal değişikliklerle yeniden kullanılabileceğini. Bu özellik, önerilen sistemde LLM’in nasıl işlev gördüğüne dair merkezi bir unsurdur; burada LLM saf bir üretken bileşen olarak değil, yapılandırılmış bakım tahminlerinin üzerinde bir çeviri katmanı olarak görev yapar (Peri ve arkadaşları, 2024). Burada kullanılan modellerin temsil kapasitesini açıklayan derin öğrenme mimarileri üzerine teorik çalışmalar (LeCun ve arkadaşları, 2015) ve sıralama modellemesi (Hochreiter ve Schmidhuber, 1997) yer alıyor. Modern LLM’lerin kalbinde yer alan transformer mimarisinin temeli, Vaswani ve arkadaşları (2017) tarafından tanıtılan dikkat mekanizmasıdır; transformer modelleri, endüstriyel IoT bağlamında titreşim sinyallerinden ekipman sağlığını değerlendirip tahmin ederek bakım tahmininde kullanılmıştır (Qi ve arkadaşları, 2024). Değişken çalışma koşulları altında kesme aletinin kalan kullanım ömrünü tahmin etmek gibi örneklerde, LSTM ağları gibi geri bildirimli alternatifler yaygın olarak kullanılmaya devam etmektedir (Zhou ve arkadaşları, 2019). Endüstriyel terminolojinin daha sonra bakım diyalogunda kullanılan önceden eğitilmiş modeller tarafından nasıl yorumlandığını açıklayan dağıtık sözcük temsilleri (Mikolov ve arkadaşları, 2013), derin öğrenme ve üretken mimarilerin daha geniş teorik temelleri (Goodfellow ve arkadaşları, 2016) ise bu çalışmada kullanılan Llama 3.2 modelinin yeteneklerini açıklayıcı nitelik taşır.
2.4 Son yıllardaki gelişmeler
Bu alandaki en son çalışmalar, tahmine dayalı bakımı daha yüksek doğruluk düzeyine taşıdı. Konvolüsyonel ve döngüsel katmanları birleştiren hibrit derin öğrenme mimarileri, çok değişkenli telemetri verisinden makine arızalarını öngörmek amacıyla kullanıldı: Wahid ve ark. (2022), saatlik voltaj, basınç, titreşim ve dönüş okumalarında hibrit CNN-LSTM modelinin yalnızca CNN ve yalnızca LSTM modellerinden üstün olduğunu gösterdi; ancak bu sonuçlar, ERP yalnızca sistemlerde bulunmayan yüksek frekanslı durum izleme verisine (Yugesh ve ark., 2024) dayanmaktadır. LLM tarafında Meta AI (2024), 1B–8B parametre aralığındaki açık ağırlıklı modellerin özel sistemlerle alan odaklı akıl yürütme görevlerinde rekabet edebildiğini ve aynı zamanda standart donanımlarda tam olarak çalıştırılabildiğini gösteren Llama 3’ü yayınladı; bu gelişme, önerilen sistemde Llama 3.2’nin seçilmesini doğrudan motive eden bir durum oluşturdu. Paralelde Malyi ve ark. (2025), yapılandırılmamış rüzgar türbini bakım günlüklerini etiketlemek amacıyla özel ve açık kaynaklı LLM’leri karşılaştırdı; modeller arasında belirgin farklar, hiçbir modelin tamamen doğru olmadığı ve insanın döngüye dahil edilmesi yaklaşımının önerilmesi bulgularını ortaya koydular; bu bulgu, mevcut sistemde benimsenen dayanak ve reddetme güvenlik önlemleriyle tutarlıdır. Chen ve ark. (2021), öğrenilmiş ve elle oluşturulan özellikleri birleştiren ve en bilgilendirici özelliklerle zaman adımlarına ağırlık veren dikkat mekanizmasıyla bir LSTM ağını birleştiren bir yaklaşım kullandı; bu sayede kalan kullanılabilir ömrün tahminini geliştirdiler. Bontempi ve ark. (2013) ise zaman serisi tahmininde kullanılan makine öğrenimi stratejilerini daha geniş bir çerçevede gözden geçirdi. Jain ve ark. (1996), bu ilerlemelerin ölçülebileceği bir temel olarak sinir ağlarının tarihsel gelişimini gözden geçirdi; Goodfellow ve ark. (2016) bu yaklaşımlara ortak olan derin öğrenme temellerinin klasik ders kitabı yaklaşımını sundu; Fink ve ark. (2020) ise tahmine dayalı bakım ve sağlık yönetimi alanında derin öğrenmenin daha geniş zorluklarını ve gelecek yönlerini çizdi.
2.5 Araştırma boşluğu
Öngörülü bakımı, kurumsal veri analitiği ve endüstriyel büyük dil modellerinin (LLM) kullanımı her biri ayrı başlıklarında olgunlaşmış araştırma alanları olsa da, henüz hiçbir çalışma bu üç alanı da tek bir işlevsel sistemde birleştirmemiştir. Tablo 1, incelenen çalışmaların altı temel yeteneği özetlemektedir. Yüksek makine öğrenimi doğruluğu bildiren mevcut çalışmalar genellikle tamamen kurumsal ortamlarda bulunmayan sensör veya IoT veri akışlarına dayanırken, endüstriyel büyük dil modelleri araştırmaları henüz öngörülü bakım bağlamına uygulanmamıştır; incelenen hiçbir çalışma bu altı yeteneği aynı anda ele almamaktadır. Burada elde edilen %57,08 doğruluk, çoğunluk sınıfı temelinden istatistiksel olarak ayırt edilemez (Bölüm 4.1.4) ve sensör odaklı araştırmalardan daha düşüktür; bu beklenen bir durumdur, çünkü sistem yalnızca operasyonel meta verilerden yararlanmakta, sıcaklık, titreşim veya kullanım ömrü gibi özellikleri içermemektedir. Ancak sistem, daha fazla veri birikçe bu açığı yarı yarıya kapatmak üzere tasarlanmıştır. Sınıflandırıcı seçimindeki gerekçeler Tablo 2’de özetlenmiştir.
Tablo 1
Tablo 2
Önerilen sistem ile mevcut yaklaşımların sistematik karşılaştırması.
Algoritma seçim gerekçesi.
3 Malzemeler ve yöntemler
3.1 Sistem mimarisi
Mimari, sunum katmanı, mantık katmanı ve veri katmanı olmak üzere üç katmandan oluşmaktadır. Sunum katmanı, bitki temalı bir tema üzerinden yöneticilerin ve izleyicilerin giriş yapabileceği index.html sayfası, yapay zeka yanıtlarının sürekli olarak aktığı ana sohbet arayüzü olan chat.html sayfası ve ekipman arızası bildirimini gösteren bildirim zili simgesi bulunan bu sayfada, ekipman kayıtları ile fuzzy eşleştirme (bulanık eşleştirme) işlemleri gerçekleştirilir; ayrıca arıza kayıtları eklerken doğrulama sağlanan ve Excel dosyası kullanılarak toplu yükleme imkanı sunan add_record.html sayfası üzerinden kullanıcı arayüzünü sunar. Mantık katmanı, uygulamanın iş mantığını Python kodu kullanarak yürütür. Flask’ı arka uç web sunucusu olarak kullanan Server.py, giriş/kayıt, sohbetbot iletişimi, tahmin, bildirim ve günlük kaydı faaliyetleri dahil olmak üzere 15’den fazla REST API uç noktasını barındırır. Predictor.py, eğitilmiş Rastgele Orman (Random Forest) modelini ve uyarlanmış kodlayıcıları (encoders) kullanarak ekipman arızalarını tahmin eder. Llamachat.py, Llama 3.2 ile sohbet kayıtlarını kaydeder ve yanıtları Ollama üzerinden geri gönderir. fuzzymatch.py, kullanıcı tarafından verilen ekipman adlarını ekipman kayıtlarıyla eşleştirmek için güven eşiği %60 olan bulanık dize eşleştirme algoritmasını kullanır. Veri katmanı, kullanıcı kimlik bilgileri ve bakım detayları gibi uygulamanın verilerini SQLite veritabanında saklar; eğitilmiş tahmin modelini ve kodlayıcıları (pickle dosyaları) da burada depolanır.
3.2 Makine öğrenimi metodolojisi iş akışı
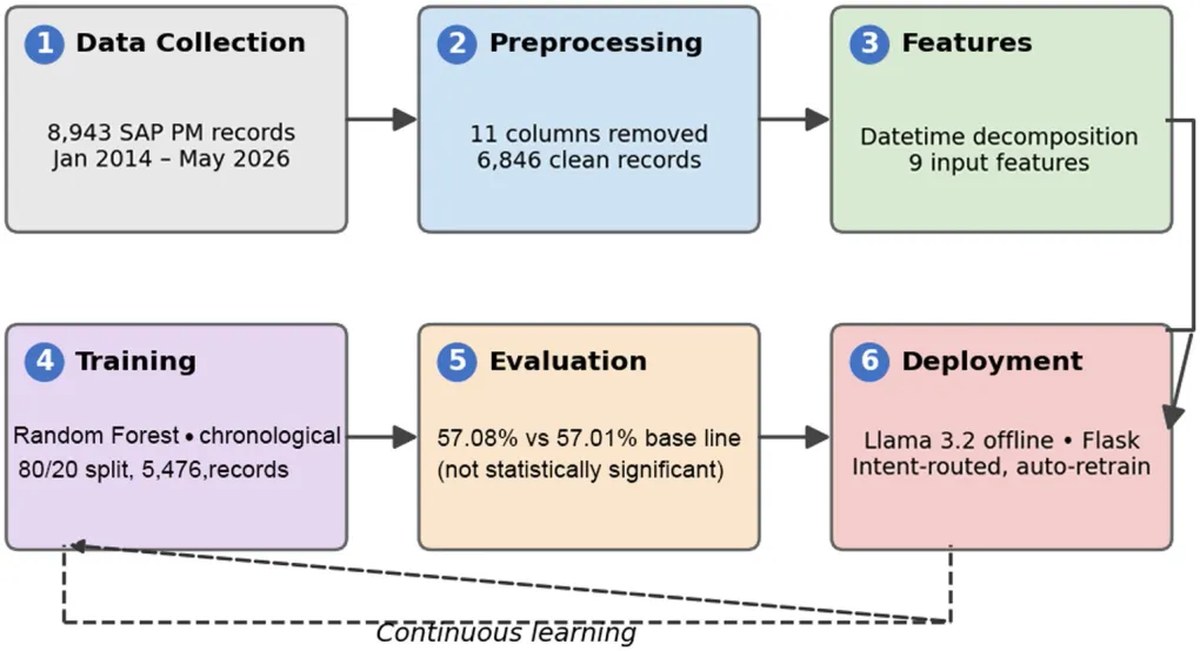
Sistem, yeniden üretilebilir ve otomatik adımlar aracılığıyla ham SAP PM (Planlı Bakım) kayıtlarını operasyonel tahminlere dönüştüren yapılandırılmış altı aşamalı bir makine öğrenimi metodolojisini izler (Şekil 1). Bu aşamalar şunlardır: (1) veri toplama—Ocak 2014 ile Mayıs 2026 arasında uzanan 8.943 SAP PM kaydı; (2) ön işleme—11 sütun kaldırılarak 6.846 temiz kayıt elde edilmesi; (3) özellik mühendisliği—zaman damgasının dokuz giriş özelliğine ayrıştırılması; (4) eğitim—%80/%20 bölünme ile 5.476 eğitim kaydının oluşturulması; (5) değerlendirme—%57,01’lik çoğunluk sınıfı temel çizgisine karşı %57,08 test doğruluğu (istatistiksel olarak anlamlı bir fark yok; McNemar testi, p = 1,00); ve (6) dağıtım—Flask üzerinden sunulan çevrimdışı Llama 3.2 asistanı ile yeni verilerde otomatik yeniden eğitim.
Şekil 1
3.3 Fonksiyonel Modüller
Veri işleme modülü, veri keşfi, temizleme ve özellik mühendisliği adımlarını uygulayarak SAP Bitki Bakım veri setini çıkarır, temizler ve işler. Ham veri seti 8.943 kayıttan ve 21 özelliğinden oluşmaktadır. Ön işleme aşamasında 11 gereksiz sütun kaldırılmış, tutarsız tarih formatları standartlaştırılmış, eksik değerler imleme ve satır silme yöntemleriyle yönetilmiş ve hedef değeri 365 günden fazla olan uç değerler kesilmiştir. Yıllar, aylar, haftanın günleri, saatler ve çalışma vardaları gibi zamanla ilgili özellikler tarih sütunlarından oluşturulmuştur. Etiket (sonraki arıza günleri), her cihaz için bildirimlerin artan tarih sırasına göre sıralanarak bir sonraki arızaya kadar geçen gün sayısının hesaplanmasıyla elde edilmiştir. Eğitim/test bölüşümü zamanlı bir yöntem kullanılmış; 80. yüzdelenin tarihinden önceki tüm veriler eğitim için, geri kalan veriler ise test için kullanılmıştır. Etiket kodlaması yalnızca eğitim verisine uyarlanmış ve ardından ekipman, öncelik, bildirim türü, fonksiyonel konum ve vardiya alanları için test verisine uygulanmıştır. Tahmin modülü, sunucu başlatıldığında eğitilmiş Rastgele Orman modelini ve uyarlanmış kodlayıcıları yükleyerek hem tek cihaz tahmini hem de tüm 447 cihaz üzerinden toplu tahmin desteği sağlar. Tek cihaz tahmininde, seçilen cihaz ve kodlanmış güncel tarih özellikleri bir sonraki arıza gününü tahmin etmek için kullanılırken, toplu tahminde tüm 447 cihaz işlenir ve tahmini arıza tarihine göre sıralanır. Sohbet yapay zeka modülü, Server-Sent Events (SSE) üzerinden anlık, düşük gecikmeli yanıtlar üretmek için Ollama API üzerinden Llama 3.2 modelini kullanır ve bu süreçte bellekte tutulan sohbet geçmişinden faydalanır. Bulanık eşleştirme modülü, kullanıcıların girdiği ekipman adlarını doğru ekipman kaydıyla eşleştirmek için Levenshtein mesafesine dayanan ve 0,60 güven eşiğine sahip FuzzyWuzzy kütüphanesini kullanır.
3.4 Sürekli İzleme ve Güvenlik
Kimlik doğrulama modülü, rol tabanlı yetkilendirmeyi üç doğrulama aşaması aracılığıyla uygular: alan adı kontrolü, kullanıcının e-postasının atanmış rolüyle tutarlı olduğunun doğrulanması ve depolanan sistem hashine eşleştirilen SHA-256 parola şifrelemesi. Sistem, Admin ve Viewer olmak üzere iki rolü destekler; her biri farklı yetkilere sahiptir. İzleme modülü, bir kullanıcı sisteme giriş yaptığında veya bildirim uç noktası başka bir şekilde çağrıldığında, tüm 447 parçanın risk durumunu tahmin eder; ardından bu çıktıyı filtreleyerek mevcut ay içinde arızalanma olasılığı yüksek olan ekipmanları belirler. Bu işlem, kullanıcı aktivitesinden bağımsız olarak arka planda sürekli olarak çalıştırmak yerine erişim anında tetiklenir; dolayısıyla modül, katı anlamda sürekli izleme yerine talep üzerine risk kontrolü olarak daha doğru tanımlanır ve kullanıcıların aktif olarak giriş yapmadığı durumlarda bile uyarılar oluşturulması için zamanlanmış arka plan görevi (örneğin periyodik bir görev çalıştırıcı aracılığıyla) uygulaması, gelecekte yapılacak çalışmalar arasında yer alır. Yüksek riskli ekipmanlar, arayüzün sağ üst köşesindeki kalıcı bildirim zili simgesinin yanı sıra açılır uyarı ile öne çıkarılır.
3.5 Veri Seti
Çalışma, NTPC’ye ait 1.980 megawattlık kömür tabanlı termik elektrik santralinden elde edilen 8.943 bitki bakımı bildirimini kullanmış; bu bildirimler Ocak 2014 ile Mayıs 2026 arasında, ham sistemde 450 işlevsel konumda kayıtlı 447 farklı ekipmandan toplanmıştır. Veriler temizlendikten ve her ekipman için bir sonraki arıza zamanına dayalı bir etiket türetilmesinden sonra (belirli bir ekipmanın tek bir etiketli örnek üretmesi için en az iki bildirimin bulunması gerekir), 6.846 etiketli kayıt kalmıştır; bunlar 388 ekipman örneğini kapsar. Geriye kalan 59 ekipman örneği her biri yalnızca tek bir bildirime sahip olduğu için etiket üretememiştir. Model, dokuz giriş özelliği kullanır: Ekipman Kimliği, İşlevsel Konum, Öncelik ve Bildirim Tipi (hepsi kategorik), bunların yanı sıra bildirim tarihinden ve saatinden türetilen ay, haftanın günü, saat, vardiya ve yıl. Veriler bildirim tarihine göre kronolojik olarak ikiye ayrılmıştır: en erken %80 (Ocak 2014 ile 12 Haziran 2023) eğitim kümesini (5.476 kayıt) oluştururken, en son %20 (13 Haziran 2023 ile 27 Ekim 2025) ayrılmış test kümesini (1.370 kayıt) oluşturur. Ham bildirimler 1 Ocak 2014 ile 8 Mayıs 2026 arasında uzanır; etiketli alt küme ise 27 Ekim 2025’te sona erer, çünkü her ekipmanın son bildiriminin bir ardışığı olmadığından bir sonraki arıza zamanına dayalı etiket üretilemez. Zaman açısından herhangi bir örtüşme yoktur ve aynı dönemin farklı bir kısmından ayrılmış bir doğrulama kümesi oluşturulmamıştır. Hiperparametre ayarlaması yalnızca eğitim kümesi üzerinde, zaman serisi çapraz doğrulama kullanılarak yapılmıştır (üç ileri zincirleme katman, her doğrulama katmanı zaman açısından ilgili eğitim katmanından kesinlikle sonra gelir) ve test kümesi yalnızca model seçimi tamamlandıktan sonra tek seferde değerlendirilmiştir. Kategorik kodlayıcılar (ekipman, işlevsel konum, öncelik, bildirim tipi ve vardiya için) yalnızca eğitim kümesinde eğitilmiştir; test döneminde ilk kez görünen 14 ekipman örneği ve 14 işlevsel konum, eğitim dönemi kodlamasını sessizce yeniden kullanmak yerine açık bir görülmeyen kategori işareciyle eşlenmiştir. Özellikle, risk sınıfı dengesi iki dönem arasında önemli ölçüde değişmektedir (YÜKSEK risk: eğitim kayıtlarının %43,9’u ile test kayıtlarının %57,0’u), bu da
2.2 bölümünde tartışılan kavram kayması, yani durağan olmayan altta yatan bir dağılım söz konusu olduğu için, test dönemindeki çoğunluk sınıfı temel değeri (57,01%), Tablo 3’te verilen ham veri setindeki HIGH riskli kayıtların oranıyla farklılık göstermektedir. Verilerin tek bir istasyondan elde edilmesi nedeniyle, bu sonuçlar kapasitesi, teknolojisi veya çalışma uygulamaları farklı olan tesislere doğrudan genellenemeyebilir; gelecekteki çalışmaların yaklaşımı çoklu tesisli bir veri setinde doğrulamalı veya alan uyumlandırma yöntemlerini kullanmalıdır.
Tablo 3
| Risk sınıfı | Kayıt sayısı | Yüzde |
|---|---|---|
| YÜKSEK | 3.185 | 46,5% |
| ORTA | 1.701 | 24,8% |
| DAŞ | 1.960 | 28,7% |
Risk sınıfı dağılımı.
3.6 Rastgele Orman sınıflandırıcısı
Rastgele Orman sınıflandırıcısı (Breiman, 2001), dört alternatif algoritma ile karşılaştırıldı: Lojistik Regresyon, Destek Vektör Makinesi (SVM), Karar Ağacı ve Çok Katmanlı Perseptron. Bu algoritmalar hepsi scikit-learn ortamında (Pedregosa ve ark., 20011) uygulandı ve yukarıda açıklanan aynı zaman serisi çapraz doğrulama yöntemiyle hafifçe ayarlandı; böylece daha önceki sürümde varsayılan hiperparametrelerle bırakılmışlardı. Ayarlamadan sonra Rastgele Orman’ın eğitim/test doğruluk aralığı 59,9%/57,1% seviyesine indi ve ciddi aşırı öğrenme izlerini ortadan kaldırdı (önceden varsayılan, ayarsız ayarlar altında 99,9%/50,5% idi). Kalan aralık, hafif bir varyans derecesiyle tipik bir topluluk modeli davranışı gösteriyor, ezberlemeye değil. Rastgele Orman, hem kategorik hem de sayısal veriyi işleyebildiği, özellik ölçeklemesi gerektirmeden gürültüye ve eksik değerlere dayanıklı olduğu ve özellik önem sıralaması sağladığı için üretim ortamı sınıflandırıcısı olarak seçildi. Ancak Tablo 4’te görüldüğü gibi, aynı protokol altında ayarlanan Karar Ağacı, Lojistik Regresyon veya SVM’den anlamlı derecede farklı olmamasına rağmen, dört algoritmanın hiçbiri çoğunluk sınıfı temel çizgisini istatistiksel açıdan anlamlı biçimde aşmadı (Bölüm 4.2.4). Daha önceki bu karşılaştırma sürümü, tüm sekiz aday algoritmayı aynı veri bölüntülerinde (5.476 eğitim kaydı, 1.370 test kaydı, aynı rastgele tohum) yalnızca ayarsız, varsayılan hiperparametrelerle eğitti; o protokol altında Rastgele Orman en yüksek test doğruluğunu elde etmiş gibi görünüyordu ve bu da onun orijinal seçilmesini motive etti. Algoritmalar hiperparametrelere duyarsılıklarında farklılık gösterdiği için bu, adil bir karşılaştırma temeli değildi. Tablo 4 ise bu ortamda yeniden eğitilebilen beş algoritmanın hepsinden, yukarıda açıklanan aynı zaman serisi çapraz doğrulama protokolü altında hafifçe ayarlanmış sonuçları raporlar. Bu düzeltilmiş, ayarlanmış referans noktasında (Tablo 4), Karar Ağacı en yüksek test doğruluğunu elde etti (57,45%) ve Lojistik Regresyon (57,23%), Rastgele Orman (57,08%) ve SVM (56,64%)’dan çok az önde kaldı; Çok Katmanlı Perseptron ise diğerlerinden geride kaldı (50,58%). Bu farkların hiçbiri, 57,01% çoğunluk sınıfı temel çizgisiyle karşılaştırıldığında büyük değildir ve Bölüm 4.2.4
Random Forest ile temel model arasındaki farkın istatistiksel olarak anlamlı olmadığı görülmektedir. XGBoost, LightGBM ve CatBoost, bu tabloda yalnızca varsayılan hiperparametrelerle önceki çalışmada raporlanmış olup, düzeltilmiş protokol altında bu ortamda yeniden değerlendirilememiş ve tutarsız bir karşılaştırma altında üretilen sayıları korumak yerine burada atlanmıştır; bu modellerin aynı ayar protokolunda yeniden çalıştırılması gelecekteki çalışmalar için bırakılmıştır.
Tablo 4
| Algoritma | Eğitim Doğruluğu | Test Doğruluğu | Karar |
|---|---|---|---|
| Mantıksal regresyon | 46,4% | 57,23% | Temel modelle karşılaştırılabilir |
| Desteklenen küme makinesi (SVM) | 48,5% | 56,64% | Temel modelle karşılaştırılabilir |
| Karar ağacı | 52,4% | 57,45% | Temel modelle karşılaştırılabilir |
| Nöral ağ (MLP) | 53,6% | 50,58% | Temel modelin altında |
| XGBoost | Uygulanamaz | Uygulanamaz | Yeniden değerlendirilmedi (düzeltilmiş çalışmada paket kullanılamadı) |
| LightGBM | Uygulanamaz | Uygulanamaz | Yeniden değerlendirilmedi (düzeltilmiş çalışmada paket kullanılamadı) |
| CatBoost | Uygulanamaz | Uygulanamaz | Yeniden değerlendirilmedi (düzeltilmiş çalışmada paket kullanılamadı) |
| Random Forest | 59,92% | 57,08% | Seçildi (temel modelden istatistiksel olarak anlamlı farklı değil) |
Algoritma performans sonuçları (aynı kronolojik eğitim/test bölünmesi, her algoritma eğitim kümesinde zaman serisi çapraz doğrulama ile ayarlanmıştır).
3.7 Llama 3.2 entegrasyonu
Sohbet arayüzü için Llama 3.2 1B, yerel dağıtım yeteneği, açık kaynak lisansı ve 8 GB RAM sistemleriyle uyumlu olan 1,3 GB model boyutu gibi özellikleri nedeniyle seçilmiştir. Entegrasyon, gerçek zamanlı aktarım için Sunucu Gönderilen Olaylar kullanır; Ollama sohbet API’sinden token üretir ve yanıt tamamlanana kadar üretilen her tokenu istemciye iletir. Sistemin sunduğu başlıca Flask API uç noktaları Tablo 5’te listelenmiştir.
Tablo 5
| Uç Nokta | Yöntem | Açıklama |
|---|---|---|
| /login | POST | Kullanıcı kimlik doğrulama |
| /logout | POST | Oturum sonlandırma |
| /api/chat | POST | LLM ile akışkan sohbet |
| /check-session | GET | Oturum doğrulama |
| /notifications | GET | Bu ayın uyarıları |
| /upcoming-defects | GET | Ay aralığına göre kusurlar |
| /monthly-defects | GET | Belirli bir ay için kusurlar |
| /add-record | POST | Yönetici: yeni kayıt ekle |
| /upload-excel | POST | Yönetici: toplu Excel yükleme |
| /recent-records | GET | Son 5 eklenen kayıt |
| /recent-uploads | GET | Yükleme geçmişi |
| /delete-upload/:id | DELETE | 24 saat içindeki yükleme silme |
| /retrain | POST | Manuel yeniden eğitme tetikleyici |
| /training-status | GET | Model eğitimi bilgileri |
Ana Flask API uç noktaları.
3.8 Otomatik yeniden eğitim boru hattı
Yeni bir arıza kaydı girildiğinde, yeniden eğitim süreci otomatik olarak başlatılır. Bu sürecin daha önceki bir sürümü, her yeni kayıt için eğitim etiketini, çözüm süresinden (bildirim ile tamamlanma arasındaki farktan) türetmiş ve bunu bir sonraki arıza oluşumuna kadar geçen süre etiketi yerine kullanmıştı. Bu iki miktar kavramsal olarak farklı olduğu için, bu yaklaşım ardışık yeniden eğitimlerde etiket dağılımını bozma riski taşıyordu ve mevcut kodlayıcılarda yer almayan yeni ekipman veya kategori değerleri sessizce atlanıyordu, yani dikkate alınmıyordu. Düzeltilmiş süreç ise şu adımları izliyor: (1) her yeni arıza kaydını, ham (kodlanmamış) haliyle, o ekipmanın tüm tarihsel bildirim günlüğüne ekliyor; (2) tüm birleşik geçmiş için bir sonraki arıza oluşumuna kadar geçen süre etiketini yeniden hesaplıyor — her ekipmanın bildirimlerini kronolojik olarak sıralayıp orijinal etiket oluşturma adımında (Bölüm 3.3) olduğu gibi bir sonraki bildirime kadar olan farkı hesaplayarak — bu da yeni bir kaydın, aynı ekipman için bir sonraki bildirim gelene kadar etiketsiz kalması anlamına getiriyor, yani ona yalnızca bir yedek etiket atanmıyor; (3) kodlayıcıları, daha önce görülmeyen herhangi bir ekipman, işlevsel konum, öncelik veya bildirim türü değerini de içerecek şekilde genişletiyor, böylece bu tür kayıtlar atlanmıyor; (4) güncellenmiş geçmişin kronolojik olarak yeniden bölünmesini ve RandomForestClassifier’ın yeniden eğitilmesini sağlıyor; (5) yeni model.pkl dosyasının öncekini yerini almasını; ve (6) eğitim zaman damgasının, kayıt sayılarının ve güncellenmiş test doğruluğunun kaydedilmesini sağlıyor.
3.9 Sürekli öğrenme mimarisi ve veri kısıtlamalarıyla başa çıkma
Model, Bölüm 3.5’te anlatılan 2014–2026 yılları arasında yer alan 6.846 etiketli SAP PM kaydı üzerinde eğitildi. Gözlenen %57,08 doğruluk, istatistiksel olarak çoğunluk sınıfı temel çizgisinden (%57,01) ayırt edilemeyen bir değer (Bölüm 4.1.4)—iki temel kısıtlamayı yansıtıyor. Birincisi, eğitim yalnızca operasyonel meta verilerden (tarih, öncelik, ekipman türü, bildirim türü, vardiya) besleniyor; titreşim, sıcaklık, ekipman yaşı ve yük gibi yüksek değerli durum izleme özellikleri mevcut değil. İkincisi, 447 adet ekipman arasında birçokının kaydedilen arıza sayısı 20’den az ve bu durum ekipmana özgü desenleri güvenilir biçimde tespit etmeye yeterli değil. Bu kısıtlamaları gidermek amacıyla sistem, iki bileşenden oluşan sürekli öğrenme bir mimari uygulıyor. Kayıt düzeyinde yeniden eğitim, yeni bir arıza kaydı sohbet arayüzü veya yönetici sayfası üzerinden eklendiğinde model güncellemesini tetikler: kayıt kodlanır, eğitim kümesine eklenir ve model yeniden eğitilir. Toplu SAP yüklemesi, yöneticilerin SAP PM Excel dışa aktarım dosyalarını doğrudan yüklemesine olanak tanır; sistem gerekli sütunları kontrol eder, temel bilgiler eksik kayıtları dışlar (sorunu işaretleyerek), ardından eğitim kümesinin varsayılan değerleriyle gerekli olmayan eksik alanları doldurur ve modeli yeniden eğitir. Fabrika her yıl yüzlerce SAP bildirimi ürettiğinden, bu mimari normal çalışma boyunca tahmin kalitesini sürdürmeyi hedefler (Tablo 6).
Tablo 6
| Metric | Value |
|---|---|
| Total records | 8,943 |
| Records after cleaning | 6,846 |
| Unique equipment | 388 (of 447 total; remainder lack sufficient history) |
| Unique locations | 391 |
| Date range | Jan 2014–May 2026 |
| Features used | 9 |
| Target classes | 3 (HIGH/MEDIUM/LOW) |
Küme istatistikleri.
4 Bulgular ve tartışma
4.1 Model performansı
Bölüm 3.5’te açıklandığı gibi, veriler 5.476 kayıttan oluşan tek bir eğitim kümesi (%80) ve 1.370 kayıttan oluşan ayrılmış bir test kümesi (%20) olarak bölünmüş olup ayrı bir doğrulama dilimi kullanılmamıştır; hiperparametre ayarlaması bunun yerine eğitim kümesi içinde üç katmanlı zaman serisi çapraz doğrulama kullanılmıştır. Ayarlanmış modelin eğitim doğruluğu (%59,9) ve test doğruluğu (%57,1) birbirine yeterince yakındır ve ciddi aşırı öğrenmeyi eler, ancak test doğruluğu kendisi, çoğunluk sınıfı temel çizgisinin (%57,01) ile anlamlı düzeyde farklı değildir (Bölüm 4.2.4) (Tablo 7).
Tablo 7
| Metric | Value |
|---|---|
| Overall Accuracy | 57.08% (not significantly different from baseline, p = 1.00) |
| Training records | 5.476 (80%) |
| Test records | 1.370 (20%) |
| n_estimators | 100 |
| random_state | 42 |
| max_depth | 8 |
Model yapılandırması ve genel doğruluk.
4.1.1 Özellik önem analizi
Rastgele Orman modeli tarafından elde edilen Gini önem puanları Tablo 8’de gösterilmektedir; bu tabloda saat eksik bırakılan daha önceki bir sürümde yer alan tüm dokuz giriş özelliği listelenmektedir. İşlevsel Konum en belirgin faktördür ve ona Yakıt çok yakından takip eder; ancak ablatasyon çalışması (bir özelliği kaldır, yeniden eğit ve test doğruluğundaki değişimi ölç) gösteriyor ki Yakıt tamamen kaldırıldığında test doğruluğu 0,00 puanlık bir değişimle sonuçlanmaktadır. Bu durum, İşlevsel Konum’un zaten Yakıt’ın sağlayabileceği konuma özgü sinyali zaten yakaladığını ve Yakıt’ın yüksek Gini puanının benzersiz bir tahmin katkısından ziyade ağaç bölme davranışını yansıttığını göstermektedir. Bildirim Türü veya Öncelik özelliğinin tek başına kaldırılması test doğruluğunu hafifçe artırır (+2,04 ve +1,53 puanlık artışlar sırasıyla), bu da bu sınıflandırıcı için bu iki özelliğin sinyal yerine gürültü eklediğini göstermektedir. Zamanla ilgili faktörler—yıl, ay, saat ve hafta içi gün—toplam önemden önemli bir payı oluşturmakta ve bu durum, 3.5 bölümünde tartışılan kavram kayması ile tutarlıdır, sabit bir mevsimsel desen değil. Sıcaklık ve titreşim gibi durum izleme sinyallerinin önemli özellikler arasında neredeyse yokluğu, modelin doğruluğunun çoğunluk sınıfı temelinden istatistiksel olarak ayırt edilemeyecek kadar yakın olmasından (4.2.4 bölümü) kaynaklanmaktadır. %57,08’lik test doğruluğu, yalnızca operasyonel meta veri mevcut olduğunda ekipman arıza tahmininin temelde zor olduğunu göstermektedir ve bu zorluk durum izleme verisinin olmamasıyla da birleşmektedir. Sürekli izleme uygulandığında, herhangi bir kontrolde aktif dikkat gerektiren ekipman sayısı 447’den yalnızca HIGH risk olarak işaretlenenlere düşer ve bu belirlemeyi hangi sınıflandırıcı kullanırsa kullansın bağımsızdır.
Tablo 8
Random Ormanı, Gini kirliliği yöntemine dayanan özellik önem puanları.
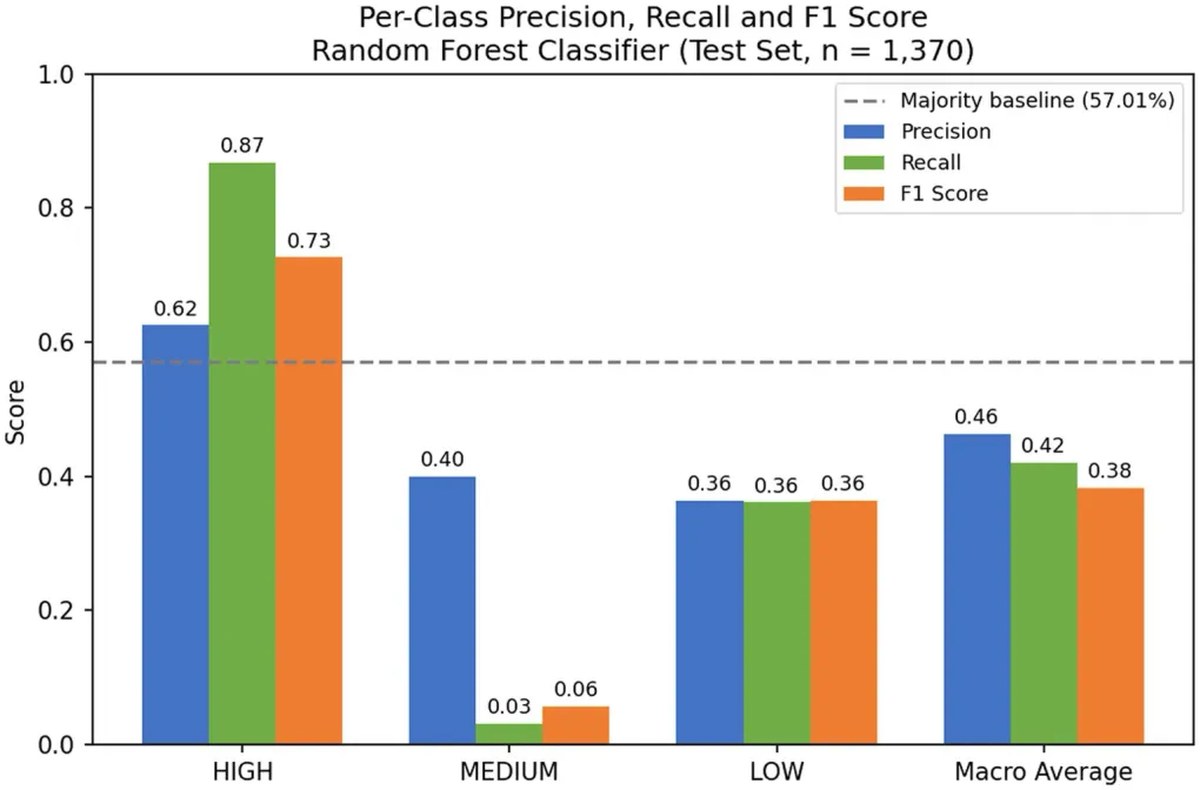
Tablo 9 ve Şekil 2, 1.370 kayıtlı test kümesinde her risk sınıfı için doğruluk, çağrılma oranı ve F1 skorunu raporluyor. HIGH risk sınıfı için çağrılma oranı (0,867), üçünden en yüksek olanı ve operasyonel açıdan en önemli sonuç, çünkü bir öğeyi HIGH risk olarak işaretlememek, yaklaşan bir arızayı tespit edemediği anlamına gelir; bu durum, HIGH sınıfının test döneminde çoğunluk sınıfı olması (kayıtların %57,0’ı) ile büyük ölçüde destekleniyor. MEDIUM, sınıflandırmada en zor sınıf, çağrılma oranı yalnızca 0,031 ile neredeyse hiç doğru tahmin edilmiyor ve neredeyse tamamen HIGH ile karıştırılıyor. Bu durum, bu analizin daha önceki bir versiyonundaki iç tutarsızlığı düzeltiyor; sınıflandırma-raporu çağrısında açık bir etiket sırası eksikliği nedeniyle oluşan bir etiketleme hatası, MEDIUM ve LOW’nin doğruluk, çağrılma oranı ve destek değerlerinin yer değiştirilmesine neden olmuştu; düzeltilmiş ve çapraz kontrol edilen Tablo 9 ve Tablo 10’daki veriler artık aynı tahminlerden üretiliyor ve programatik olarak tutarlı oldukları doğrulandı. Sınıf dengesizliği dikkate alındığında, makro ortalamalı F1 skoru (0,382), çoğunluk sınıfı temel performansının ima ettiği performanstan altında ve Bölüm 4.2.4’teki anlamsız sonuçla tutarlı.
Tablo 9
| Risk class | Precision | Recall | F1 score | Support |
|---|---|---|---|---|
| HIGH | 0.625 | 0.867 | 0.726 | 781 |
| MEDIUM | 0.400 | 0.031 | 0.057 | 326 |
| LOW | 0.364 | 0.361 | 0.363 | 263 |
| Macro average | 0.463 | 0.420 | 0.382 | 1,370 |
Sınıf başına sınıflandırma raporu (test kümesi, n = 1.370).
Şekil 2
Tablo 10
| Actual\predicted | Pred. HIGH | Pred. MEDIUM | Pred. LOW |
|---|---|---|---|
| Actual HIGH | 677 | 8 | 96 |
| Actual MEDIUM | 246 | 10 | 70 |
| Actual LOW | 161 | 7 | 95 |
Karışım matrisi (çapraz = doğru tahminler).
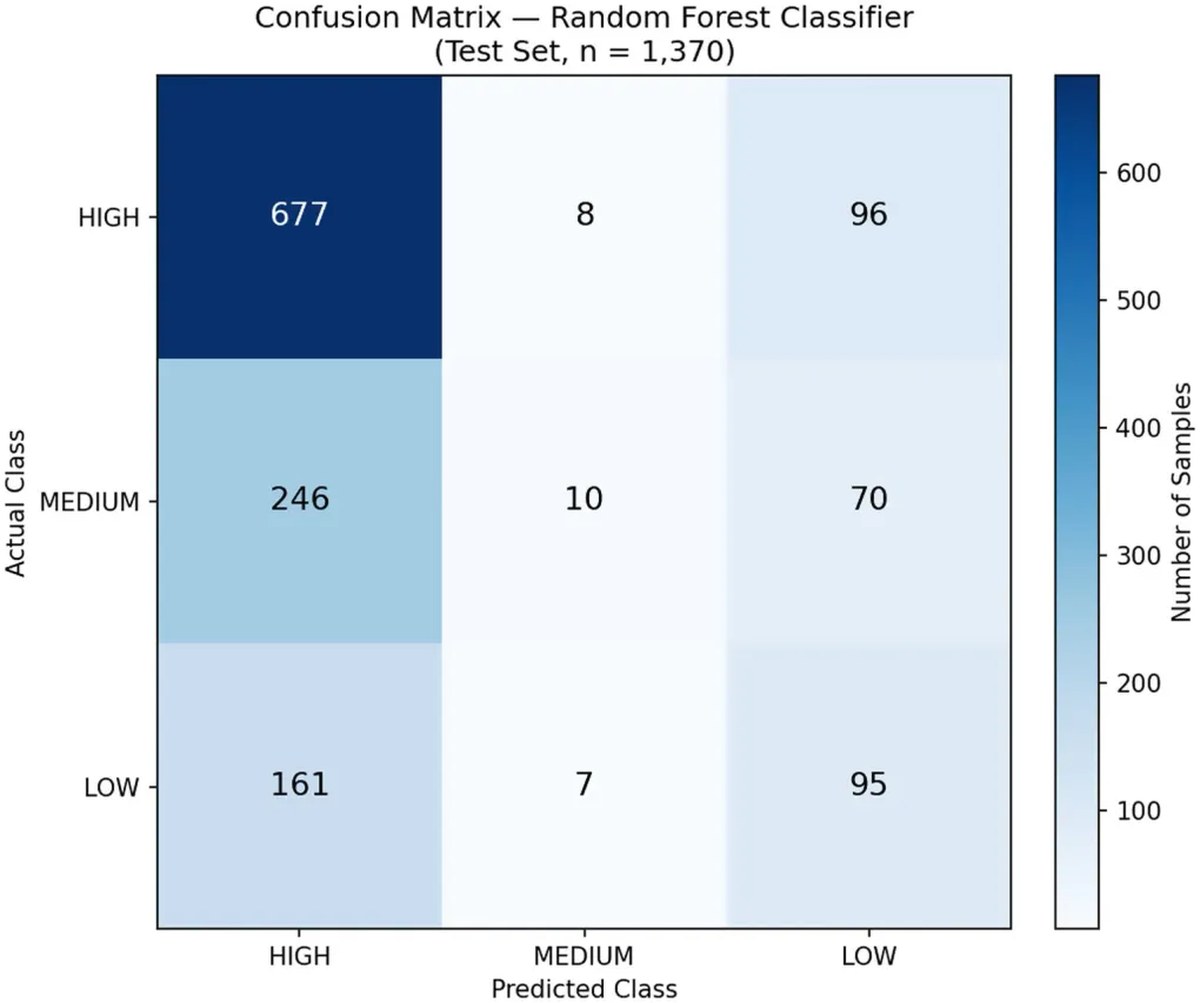
4.1.3 Karışım matrisi
Tablo 10 ve Şekil 3, üç sınıflı problem için karışıklık matrisini göstermektedir; köşegen değerler doğru sınıflandırmaları ifade etmektedir. HIGH sınıfı en yüksek doğru sınıflandırma oranına sahiptir (781’den 677’si, %86,7 hatırlama), bu da HIGH sınıfının test döneminin çoğunluk sınıfı (%57,0) olmasından kaynaklanan tutarlı bir durumdur. MEDIUM sınıfı neredeyse hiç geri kazanılmaz (326’dan 10’u doğru, %3,1 hatırlama): 326 gerçek MEDIUM kayıttan 246’sı HIGH olarak yanlış sınıflandırılır. Bu durum, 4.1.2 bölümünde belirtilen sınıflandırma raporu etiketleme hatası nedeniyle LOW’u en zor sınıf olarak gösteren, daha önce düzeltilmemiş bu tablonun versiyonundan tam tersi bir örüntüdür; düzeltilmiş matris, modelin başarısız olduğu sınıfın LOW değil MEDIUM olduğunu göstermektedir. Çoğu karışıklık komşu sınıflar arasında simetrik olmaktan ziyade HIGH’a doğru yönlendirilmiştir, bu da modelin üç risk bandını gerçekten ayırmak yerine çoğunluk sınıfına dayanmak öğrendiğini gösteren tutarlı bir durumdur. Bu nedenle, başlık doğruluk oranının yalnızca öne çıkardığından daha acil bir hedef, MEDIUM- ve LOW-riskli sınıflandırmayı geliştirmektir: gelecekteki çalışmalar için, günlerin gerçek dağılımına karşı mevcut sabit 30 ve 90 günlük risk sınıfı eşiklerini incelemek ve sistematik HIGH tahminine yönelik eğilimi azaltıp azaltmadığını değerlendirmek için olasılığa dayalı kalibre edilmiş veya sıralı regresyon formülasyonunun uygulanması, yeni veri kaynakları eklenmeden önce somut sonraki adımlardır.
Şekil 3
4.1.4 İstatistiksel anlamlılık ve güven aralıkları
10 farklı rastgele tohumda, derinlik sınırı olmadan 100 ağaç içeren ayarlanmamış bir Rastgele Orman (Random Forest) modelinin aynı kronolojik eğitim-test bölünmesi üzerinde çalıştırılması, algoritmanın içsel rastgeleliğini ölçer; ancak bu yöntem, tüm 10 çalışmanın aynı sabit test kümesini paylaşıyor olması nedeniyle, altta yatan popülasyonla karşılaştırıldığında istatistiksel açıdan anlamlı bir sonuç ortaya koymaz. 10 tohum üzerinde (Tablo 11; Şekil 4) sınıflandırıcı, aynı test döneminde çoğunluk sınıfı temel çizgisinin (57,01%) altında kalan ortalama bir test doğruluğu olan %55,26 (standart sapma 0,48) değerine ulaşmıştır. Bir-vs-geri kalan (one-vs-rest) ROC eğrileri (makro AUC = 0,724) Şekil 5’te gösterilmektedir. Anlamlılığı doğru biçimde test etmek amacıyla, McNemar testi, Rastgele Orman modelinin tahminleri ile çoğunluk sınıfı temel çizgisinin tahminleri arasında, aynı 1.370 test kaydı üzerinde (iki sınıflandırıcının da aynı örneklerde değerlendirildiği için uygun bir eşleşmiş test) uygulandı; sonuç istatistiksel açıdan anlamlı değildir (n01 = 105, n10 = 104,
p
4.2 Büyük Dil Modeli modülünün değerlendirilmesi
Llama 3.2 1B modelinin sohbet yanıtları, gecikme süresi, dayanaklılık ve uydurma oranı olmak üzere üç eksen üzerinden, tam olarak kullanılan yapılandırma (Ollama 0.33.3, sıcaklık 0.7, top-p 0.9) kullanılarak değerlendirildi; örnek bir etkileşim (Şekil 6) gösterilmektedir. Değerlendirme kümesi, dört kategoriye dağıtılmış 40 temsilci sorudan oluştu: ekipman riski soruları (örneğin, “Soğutma Kulesi 7B ne zaman arızalanacak?”), bildirim geçmişi soruları (örneğin, “Fan 06 son dönemde kaç arıza kaydetti?”), çoklu ekipman karşılaştırma soruları (örneğin, “Mevcut en yüksek riskli 5 ekipmanı sırala”) ve genel bakım yönlendirme soruları. Bu değerlendirmenin ilk versiyonu, her kelime içeren soruyu, tüm soru metniyle tek bir bulanık eşleşme üzerinden yönlendirdi; çünkü bu eşleşme ne kadar alakasız olursa olsun her zaman bazı aday ekipman döndürdüğü için, geniş kapsamlı karşılaştırma ve sıralama soruları, sanki rastgele seçilmiş, alakasız bir ekipman hakkında soruluyormuş gibi sessizce yanıtlandı ve geçmiş soruları, alttaki sistemin geriye dönük sayı çekme mekanizması bulunmayan, inandırıcı görünen arıza sayıları ve geçmiş kayıtları uydurarak cevaplandı; çünkü tahmin verileri yalnızca ileriye dönük riski kapsar, geçmiş sayıları değil. İlk 40 yanıtın elle okunması, yalnızca yaklaşık %25–30’unun hem doğru ekipmana dayandığını hem de sistemin gerçekten bilebileceği verilerle tutarlı olduğunu gösterdi; bu oran, yalnızca tek bir bildirilen risk seviyesi alanının alttaki tahminle eşleştiğini kontrol eden, doğru ekipmanın ele alındığını veya yanıtın geri kalanındaki denetlenmemiş iddiaların uydurulup uydurulmadığını sorgulamayan otomatik hesaplanan %87.5 değerinin çok altında kaldı. Yukarıdaki sorunu gidermek amacıyla, sorguları yönetme mimarisi geliştirildi; böylece her soru önce niyetine göre sınıflandırıldı, ardından uygun gerçek veri çekildi: tek ekipman riski soruları, hâlâ ekipman eşleştirmesiyle veri çekmeye devam etti ancak artık ekipman adlarının yanlış eşleşmesini önlemek için en iyi ekipman eşleşmesinin ikinci en iyi eşleşmeyi kesin biçimde geçmesini gerektirdi; karşılaştırma ve sıralama soruları ise
Bu düzeltme ile birlikte, tüm ekipmanlara ilişkin tahminleri içeren gerçek üst-N risk tablosuna sorular gönderilirken, ekipmanla ilgili geçmiş soruları o ekipmana ait bildirim günlüğüne yönlendiren bir yapı kurulmuştur. Sorunun niyetine uygun bir veri bulunamadığı durumlarda, sistem komutu modelden soruyu yanıtlamayı reddetmesini ve veri olmadığı durumlarda verilen yönergeye uygun biçimde yalnızca genel tavsiye vermesini, Equipment/Risk/Date bloğu uydurmasını önlemesini açıkça belirtmektedir. Bu düzeltilmiş mimari için, aynı 40 soruda yeniden çalıştırılan performans sonuçları Tablo 12’de verilmiştir. Genel olarak, yanıtların %55’i (40/40) güvenilir kabul edilmiştir; çünkü ya gerçek verilere atıfta bulunmuş ya da veri olmadığı durumlarda verilen yönergeye uygun biçimde reddetme yoluyla yanıt vermiştir. Bu oran, orijinal mimaride manuel olarak doğrulanan yaklaşık %25–30’dan bir iyileştirmedir. Geri kalan %45 ise iki başarısızlık biçimine düşmüştür ve bu biçimler öncekinden açıkça ayrı tutulmuştur: bazı durumlarda, geliştirilen ekipman adı eşleştirme süreci, geçerli ancak neredeyse aynı olan bir ekipman adını reddetmiştir (örneğin, aynı soğutma kulesinin yan yana yerleştirilmiş fan numaraları) ve veri bulunamadığını yanlış olarak bildirmiştir. Diğer başarısızlık vakalarının çoğunda ise model, veri bulunamadığı doğru biçimde bilgilendirilmiş olsa da, prompt düzeyindeki yönergeye aykırı olarak tamamen biçimlendirilmiş ve uydurulan bir Equipment/Risk/Date bloğu döndürmüştür. Bu durum, prompt kısıtlamalarının yalnız başına bu 1 milyar parametreli model için yeterli güvenlik önlemi olmadığını göstermektedir. Yanıt gecikmesi, yeni mimari altında daha fazla sorgu türünün doğru biçimde bağlamaya alınması nedeniyle artmıştır (genellikle 5–20 saniye; büyük bağlam tablosu gerektirdiği için karşılaştırma soruları bazen 30 saniyeyi aşmaktadır) ve bu, yalnızca tek ekipman türüne bağlamaya yönelik orijinal bağlamda bildirilen 3,4 saniyeden daha yavaştır.
Şekil 6
Tablo 12
Lanet modülünün düzeltilmiş, niyet yönlendirmeli mimari altında değerlendirilmesi—Gecikme süresi, güvenilir yanıt oranı ve uydurma/uydurma yanıt oranı (n = 40 sorgu, Llama 3.2 1B sürümü Ollama 0.33.3 üzerinden, çevrimdışı).
4.3 Bulanık eşleştirme değerlendirmesi
Bulanık eşleştirme doğruluğu (Tablo 13), beş kategori üzerinden 50 elle hazırlanmış sorguyla doğrulandı: tam eşleşme (10), büyük/küçük harf farkı (10), kısmi ad (10), kısaltma (10) ve kasıtlı yazım hataları (10). Başarılı eşleşmeler için ekipman adları önceden veritabanından seçildi; her sorgu canlı sisteme gönderildi ve getirilen sonuç doğru ekipmanla karşılaştırıldı. Bir sorgu yalnızca hedeflenen ekipman biriminin getirilmesi durumunda doğru olarak puanlandı. Levenshtein mesafesi güven eşiği %60, 40 ile 80 arasında eşiği 20 sorguda test ederek deneysel olarak belirlendi. Modül tam eşleşmelerde, büyük/küçük harf değişimlerinde ve yazım hatalarında iyi performans gösteriyor ancak kısmi adlar ve kısaltmalarda zayıf performans gösteriyor; bu da saf Levenshtein mesafesi eşleştirmesinin bu sorgu türleri için uygun olmadığını gösteriyor. Özel bir kısaltma sözlüğü veya token düzeyinde eşleştirme stratejisi, gelecekte iyileştirme için doğal bir hedefdir (Tablo 14).
Tablo 13
| Sorgu kategorisi | Ortalama gecikme (s) | Güvenilir yanıt oranı | Uydurma/uydurma yanıt oranı | n |
|---|---|---|---|---|
| Ekipman riski sorgusu | ~5 ile 15 | %60 | %40 | 10 |
| Bildirim geçmişi | ~5 ile 20 | %40 | %60 | 10 |
| Ekipman karşılaştırması | ~10 ile 30 | %80 | %20 | 10 |
| Bakım yönlendirmesi | ~5 ile 20 | %40 | %60 | 10 |
| Genel (40 sorgu) | ~5 ile 20 (uzun karşılaştırmalarda ~40’a kadar) | %55 | %45 | 40 |
| Sorgu türü | Eşleşme doğruluğu |
|---|---|
| Tam eşleşme | %100 |
| Büyük/küçük harf değişimi | %100 |
| Kısmi isim | %10 |
| Kısaltma | %0 |
| Hatalı yazım | %80 |
Bulanık eşleştirme doğruluğu.
Tablo 14
| Özellik | Durum |
|---|---|
| Ekipman arıza tahmini | Çalışıyor |
| Doğal dil sorguları | Çalışıyor |
| Yayınlanan yapay zeka yanıtları | Çalışıyor |
| Bulanık ekipman eşleştirme | Çalışıyor |
| Kullanım yetkisine dayalı kimlik doğrulama | Çalışıyor |
| Bildirim sistemi | Çalışıyor |
| Yönetici kayıtlarını yönetme | Çalışıyor |
| Toplu Excel yükleme | Çalışıyor |
| Otomatik model yeniden eğitimi | Çalışıyor |
| 24 saatlik yükleme geri alımı | Çalışıyor |
| Çevrimdışı çalışma | %100 çevrimdışı |
Sistem yetenekleri.
5 Sonuç ve gelecekteki çalışmalar
Bu makale, özel sensör altyapısı gerektirmeksizin yalnızca SAP Plant Maintenance (PM) verilerine dayanan bir tahmine dayalı bakım çerçevesini sunmaktadır. 6.846 SAP PM kaydı üzerinde eğitilen Rastgele Orman sınıflandırıcısı, test doğruluğu %57,08, makro ROC-AUC 0,724 ve HIGH-risk çağrısı 0,867 seviyesinde bir performans elde etmiştir; ancak McNemar testi ve doğruluk farkı için bootstrap güven aralığı, bu sonuçların aynı tutulan dönemde %57,01’lik çoğunluk sınıfı temelinden istatistiksel olarak ayırt edilemeyeceğini göstermektedir. Fonksiyonel konum dahil edildiğinde ekipman kimliğinin doğruluğa ölçülebilir bir katkı sağladığı ablatasyon çalışması ise, ekipman riski tahmininde ERP bakım verilerinin kendisinin güçlü ve sömürülebilir bir sinyal taşıdığını kanıtlamadan, bu düzeltilmiş sonuçların aksine, böyle bir sinyalin mevcut dokuz özellik temsili ve bu veri setinin boyutuyla algılanamayacağını, operasyonel meta verilerin durum izleme veya ekipman yaşına kadar birleştikçe tek başına bir tahminleyici yerine zayıf, tamamlayıcı bir giriş olarak ele alınması gerektiğini ortaya koymaktadır. Tek düzeltme ile yeniden yapılandırılan sorgu yönlendirme mimarisi altında çalışan çevrimdışı Llama 3.2 asistanı, niyetine uygun gerçek verileri (tek ekipman tahmini, çoklu ekipman karşılaştırma tabloları veya bildirim geçmişi) getirip böyle bir veri bulunamadığında kurgulamak yerine açıkça reddettiği bir yapıda, 40 soruluk değerlendirme setinin %55’ine doğrulanabilir şekilde güvenilir yanıtlar vermiştir; bu oran, orijinal tek anahtar kelime tetiklemeli bağlama yaklaşımı altında tahmini %25–30’dan bir artış olarak kaydedilirken, yanıt gecikmesi buna bağlı olarak 5–20 saniyeye yükselmiş ve karşılaştırma sorgularında bazen 30 saniyeyi aşmıştır. Geriye kalan güvenilir olmayan yanıtlar, aşırı katı ekipman adı eşleştirmesi ile dil modelinin periyodik olarak açık bir kurgu yapma yasağını göz ardı etmesi arasında paylaşılmış olup, her ikisi de nicelendirilmemiş genel bir halüsinasyon riski olarak değil, gelecekteki çalışmalar için somut hedefler olarak belirlenmiştir. Bulanık eşleştirme, tam, büyük/küçük harf değişkeni ve yazım hatası içeren ekipman adlarında etkili olmuştur; ancak kısmi adlar ve kısaltmalar için daha zayıf bir performans göstermiştir. Yeniden eğitim boru hattı, etiketlerin tam bildirim geçmişinden yeniden türetilmesi düzeltmesiyle güncellenmiştir.
yeni kayıtlar geldikçe, henüz gerçek bir sonraki arıza etiketine sahip kayıtların yerine çözüm-süreği bir yaklaşım kullanmak yerine bunları korumak, ve daha önce görülmeyen ekipmanlar için kategorik kodlayıcıları genişletmek yerine bu kayıtları sessizce atmak yerine onları dahil etmek amacıyla. Bu sonuçların bir arada değerlendirilmesi, kaynak kısıtlı endüstriyel tesislerde yalnızca ERP tabanlı bir tahmine dayalı bakım sisteminin mimari açıdan uygulanabilir olduğunu gösteriyor—yeniden eğitme süreci, izleme arayüzü ve niyet yönlendirmeli sohbet asistanı tasarlandığı gibi çalışıyor—ancak hata tahmin doğruluğu ve sohbet güvenilirliği, düzeltilmemiş bir değerlendirme protokolünün öne sürdüğünden daha sınırlı ve her ikisi de bu sistemin yalnızca tahminlerine dayanarak karar verilmeden önce aşağıda tartışılan ek veri kaynakları ve önlemleri gerektiriyor. Gelecek çalışmalar, ekipman yaşını bir eğitim parametresi olarak ekleyerek yaşla ilişkili arıza örüntülerini yakalayabilir ve sarsıntı ile sıcaklık verilerini mevcut ERP özellikleriyle birleştirerek sınıflandırma doğruluğunu artırabilir. Ekipman tipine özgü modeller eğitmek, sistemin her ekipman kategorisine özgü arıza örüntülerini öğrenmesine yardımcı olabilir. Mobil entegrasyon, tahminlerin üretim zemininden doğrudan erişilmesini sağlayacak, otomatik e-posta veya SMS uyarıları ise yükselmiş arıza olasılığına sahip ekipmanlar hakkında personeli proaktif olarak bilgilendirebilir. Mevcut Excel tabanlı iş akışının yerini doğrudan SAP PM API entegrasyonu alırsa idari yük azalır ve Llama modelinin bakım terimlerine özel ince ayarlanması, yanıtlarının alakasını muhtemelen artırır. Bu makaledeki sonuçların tek bir istasyondan geldiği göz önüne alındığında, bu bulguların tek bir tesisin operasyonel geçmişinin ötesine genellenip genellenmediğini belirlemeye yönelik önemli bir adım olarak, farklı kapasitelere, ekipman karışımlarına ve bakım kayıtlama konvansiyonlarına sahip ek güç santrallerinden gelen verilerde çerçeveyi doğrulamak kalmaktadır.
Beyanlar
Veri erişilebilirliği beyanı
Bu makalede sunulan veri kümeleri, NTPC Limited’e ait gizli bakım kayıtlarından oluştuğu ve kamuya paylaşılamadığı için kolayca elde edilememektedir. Veri kümelerine erişim talep edenler, NTPC Korba Süper Termik Elektrik Santrali’nden Venkateswarlu Balabommu’ya (venkat211177@gmail.com) yönlendirilmelidir.
Yazar katkıları
HB: Kavramsal çalışma, veri yönetimi, biçimsel analiz, araştırma, yöntemoloji, yazılım, görselleştirme, özgün taslak yazımı, gözden geçirme ve düzenleme yazımı. SS: Gözden geçirme ve düzenleme yazımı, doğrulama, denetimin. NV: Gözden geçirme ve düzenleme yazımı, denetimin, doğrulama. GC: Gözden geçirme ve düzenleme yazımı.
Fonlama
Yazarlar, bu çalışma için ve/veya yayımlanması için finansal destek almadıklarını beyan etmiştir.
Teşekkür
Yazarlar, SAP Plant Maintenance veri kümesine erişim sağlamaları ve bu araştırma sırasında sağladıkları değerli destek ve işbirliği için NTPC Korba Süper Termik Elektrik Santrali’nin yönetim ve bakım ekibine içten teşekkürlerini sunarlar. Çalışmanın gerçekleştirilmesine izin vermeleri, önerilen tahmine dayalı bakım sisteminin geliştirilmesini ve değerlendirilmesini mümkün kılmıştır.
Çakışma ilgisi
Yazarlar, bu çalışmanın potansiyel bir çakışma olarak yorumlanabilecek ticari veya finansal ilişkilerin yokluğunda yürütüldüğünü beyan etmiştir.
Üretken yapay zeka beyanı
Yazarlar, bu makalenin oluşturulmasında üretken yapay zekanın kullanıldığını beyan etmiştir. Figure 1’deki iş akışı diyagramının oluşturulması, dil düzenlemesi, makalenin dergi gereksinimlerine göre biçimlendirilmesi ve özeti, öne çıkan başlıklar ve kapsam beyanının taslak yazımında Claude (Anthropic) kullanılmıştır. Yazarlar tüm içeriği gözden geçirmiş, doğrulamış ve bunun sorumluluğunu üstlenmişlerdir.
Bu makalede figürlerin yanında verilen alternatif metinler (alt text), Frontiers tarafından yapay zekanın desteğiyle oluşturulmuş olup doğruluğu sağlamak için makul çabalar gösterilmiştir; mümkün olduğunda yazarların da gözden geçirmesi sağlanmıştır. Herhangi bir sorun tespit ederseniz, lütfen bizimle iletişime geçin.
Yayıncının notu
Bu makalede ifade edilen tüm iddialar yalnızca yazarların kendi görüşleridir ve gerek kuruluşlarına, gerek yayıncıya, editörlere ve değerlendiricilere, gerekse ürünün üreticisinin yapabileceği herhangi bir iddiayı yansıtmaz. Bu makalede değerlendirilebilecek herhangi bir ürün veya üreticisinin yapabileceği herhangi bir iddia, yayıncı tarafından garanti edilmez veya desteklenmez.
-
Bontempi G., Ben Taieb S., Le Borgne Y.-A. (2013). “Zaman serisi tahminlemesi için makine öğrenimi stratejileri,” Business Intelligence içinde, (Berlin: Springer), 62–77. doi: 10.1007/978-3-642-36318-4_3
- CrossRef
- Google Scholar
-
Bousdekis A., Magoutas B., Apostolou D., Mentzas G. (2015). Durum tabanlı bakım için proaktif bir karar verme çerçevesi. Ind. Manag. Data Syst.115, 1225–1250. doi: 10.1108/IMDS-03-2015-0071
- CrossRef
- Google Scholar
-
Breiman L. (2001). Rastgele ormanlar. Mach. Learn.45, 5–32. doi: 10.1023/A:1010933404324
- CrossRef
- Google Scholar
-
Brown T., B. Mann, B. Ryder, N. Subbiah, M. Kaplan, P. Dhariwal ve diğerleri (2020). Dil modelleri az örnekle öğrenenlerdir. Adv. Neural Inf. Process. Syst.33, 1877–1901.
- Google Scholar
-
Canizo M., Onieva E., Conde A., Charramendieta S., Trujillo S. (2017). Büyük veri çerçeveleriyle rüzgâr türbinleri için gerçek zamanlı tahminleyici bakım, IEEE Prognostics and Health Management Uluslararası Konferansı Proceedings’inde (IEEE). 70–77. doi: 10.1109/ICPHM.2017.7998308
- CrossRef
- Google Scholar
-
Chen Z., Wu M., Zhao R., Guretno F., Yan R., Li X. (2021). Dikkat tabanlı derin öğrenme yaklaşımıyla kalan kullanılabilir ömür tahmini. IEEE Trans. Ind. Electron.68, 2521–2531. doi: 10.1109/TIE.2020.2972443
- CrossRef
- Google Scholar
Bu bölüm, kaynak metninde yalnızca akademik referansların listelendiği bir kaynakça parçasıdır; bu nedenle bu parçayı Türkçeye sadık bir şekilde aktarırken, orijinal metindeki referansların yazarlarını, yıllarını, başlıklarını, dergilerini, sayfa aralıklarını ve DOI numaralarını olduğu gibi koruyarak, yalnızca “CrossRef”, “Google Scholar”, “Pubmed Abstract” gibi bağlantı etiketlerini Türkçe karşılıklarıyla (Çapraz Referans, Google Akademik, PubMed Özet) yeniden sunan HTML biçiminde bir çeviri aşağıda verilmiştir.
-
Fink, O.; Wang, Q.; Svensen, M.; Dersin, P.; Lee, W.-J.; Ducoffe, M. (2020). Derin öğrenmenin tahmin ve sağlık yönetimi uygulamalarındaki potansiyeli, zorlukları ve geleceğe dönük yönler. Eng. Appl. Artif. Intell. 92:103678. doi: 10.1016/j.engappai.2020.103678
- Çapraz Referans
- Google Akademik
-
Goodfellow, I.; Bengio, Y.; Courville, A. (2016). Derin Öğrenme. Cambridge: MIT Press.
- Google Akademik
-
Hochreiter, S.; Schmidhuber, J. (1997). Uzun kısa süreli hafıza. Neural Comput. 9, 1735–1780. doi: 10.1162/neco.1997.9.8.1735,
- PubMed Özet
- Çapraz Referans
- Google Akademik
-
Jain, A. K.; Mao, J.; Mohiuddin, K. M. (1996). Yapay sinir ağları: bir eğitim kılavuzu. Computer 29, 31–44.
- Google Akademik
-
Jardine, A. K. S.; Lin, D.; Banjevic, D. (2006). Duruma dayalı bakım uygulayan makine tanı ve tahminine dair bir inceleme. Mech. Syst. Signal Process. 20, 1483–1510. doi: 10.1016/j.ymssp.2005.09.012
- Çapraz Referans
- Google Akademik
-
Kans, M.; Ingwald, A. (2008). Bakım performansının maliyet etkin biçimde iyileştirilmesi için ortak bir veritabanı. Int. J. Prod. Econ. 113, 734–747. doi: 10.1016/j.ijpe.2007.10.008.
- Çapraz Referans
- Google Akademik
-
Kolokas, N.; Vafeiadis, T.; Ioannidis, D.; Tzovaras, D. (2018). Makine öğrenmesi sınıflandırıcıları kullanılarak endüstriyel ekipman arızalarının tahmini. Proceedings of the IEEE Conference. IEEE. doi: 10.1109/INISTA.2018.8466309
- Çapraz Referans
- Google Akademik
-
LeCun, Y.; Bengio, Y.; Hinton, G. (2015). Derin öğrenme. Nature 521, 436–444. doi: 10.1038/nature14539,
- PubMed Özet
- Çapraz Referans
- Google Akademik
Bu bölüm, referans eserlerin tam metin çevirisidir; orijinal akademik kayıtların biçim ve içeriğini korur.
-
Lee J. W., Wu F., Zhao W., Ghaffari M., Liao L. ve Siegel D. (2014). Döner makine sistemleri için tahmine dayalı bakım ve sağlık yönetimi tasarımı—gözden geçirme, yöntemoloji ve uygulamalar. Mech. Syst. Signal Process.42, 314–334. doi: 10.1016/j.ymssp.2013.06.004
- CrossRef
- Google Scholar
-
Lei Y., Li N., Guo L., Li N., Yan T. ve Lin J. (2018). Makine sağlığının tahmine dayalı bakımı: veri toplama aşamasından kalan kullanışlı ömür tahminine kadar sistematik bir gözden geçirme. Mech. Syst. Signal Process.104, 799–834. doi: 10.1016/j.ymssp.2017.11.016
- CrossRef
- Google Scholar
-
Liu H., Liu Z., Jia W. ve Lin X. (2021). Yeni bir özellik dikkati temelli uçtan uca yaklaşım kullanarak kalan kullanışlı ömür tahmini. IEEE Trans. Ind. Inform.17, 1197–1207. doi: 10.1109/TII.2020.2983760
- CrossRef
- Google Scholar
-
Li X., Ding Q. ve Sun J.-Q. (2018). Tahmine dayalı bakımda derin sarmal sinir ağları kullanarak kalan kullanışlı ömür tahmini. Reliab. Eng. Syst. Saf.172, 1–11. doi: 10.1016/j.ress.2017.11.021.
- CrossRef
- Google Scholar
-
Malyi M., Shek J., McDonald A. ve Biscaya A. (2025). Rüzgâr türbini bakım günlüklerini etiketlemek için büyük dil modellerinin karşılaştırmalı bir performans değerlendirmesi. IET Renew. Power Gener. doi: 10.1049/rpg2.70212
- CrossRef
- Google Scholar
-
Medjaher K., Tobon-Mejia D. A. ve Zerhouni N. (2012). Yataklar için uygulamaya yönelik kritik bileşenlerin kalan kullanışlı ömrünün tahmini. IEEE Trans. Reliab.61, 292–302. doi: 10.1109/tr.2012.2194175
- CrossRef
- Google Scholar
-
Meta AI (2024). Llama 3: Açık Ağırlıklı Temel Modellerimizin Sonraki Neslini Tanıtıyoruz. Meta AI Araştırma Blogu. Erişim: https://ai.meta.com/blog/meta-llama-3/ (Erişim tarihi: Nisan 2024).
- Google Scholar
Mikolov, T., Sutskever, I., Chen, K., Corrado, G. S. ve Dean, J. (2013). Kelimelerin ve ifadelerin dağıtık temsilleri ve bunların bileşkenliği. Adv. Neural Inf. Process. Syst. 26, 3111–3119.
Google Scholar
Mobley, S. (2002). Bakıröncü Bakımın Girişi. 2. Baskı, Amsterdam: Butterworth-Heinemann.
Google Scholar
Motaghare, O., Pillai, A. S. ve Ramachandran, K. I. (2018). Bakıröncü bakım mimarisi, 2018 IEEE Uluslararası Hesaplamalı Zeka ve Bilim Araştırması Konferansı (ICCIC) içinde. Madurai: IEEE, s. 1–4. doi: 10.1109/ICCIC.2018.8782406
CrossRef
Google Scholar
Nectoux, P., Gouriveau, R., Medjaher, K., Ramasso, E., Chebel-Morello, B., Zerhouni, N. ve diğerleri (2012). PRONOSTIA: yatakların hızlandırılmış bozulma testleri için deneysel bir platform, IEEE Prognostics ve Sağlık Yönetimi Konferansı proceedings. Denver: IEEE, s. 1–8.
Google Scholar
Pedregosa, F., Varoquaux, G., Gramfort, A., Michel, V., Thirion, B., Grisel, O. ve diğerleri (2011). Scikit-learn: Python’da makine öğrenmesi. J. Mach. Learn. Res. 12, 2825–2830.
Google Scholar
Peri, S. D. B., Santhanalakshmi, S. ve Radha, R. (2024). “Retrieval-augmented generation modeliyle tıbbi kitaplara sohbet etmek için bir sohbetbot,” 2024 IEEE North Karnataka Bölge Bayrak Uluslararası Konferansı (NKCon) içinde (Bagalkote: IEEE), s. 1–5. doi: 10.1109/NKCon62728.2024.10774900
CrossRef
Google Scholar
Pham, D. T. ve Pham, P. T. N. (1999). Mühendislikte yapay zeka. Int. J. Mach. Tools Manuf. 39, 937–949. doi: 10.1016/s0890-6955(98)00076-5
CrossRef
Google Scholar
Qi, Z., Du, L., Huo, R. ve Huang, T. (2024). IIoT’da kimlik çözümlemesi ve transformatörlere dayalı bakıröncü bakım. Future Internet 16:310. doi: 10.3390/fi16090310
CrossRef
Google Scholar
-
Ran Y., Zhou X., Lin P., Wen Y., Deng R. (2019). Tahminli bakıma dair bir inceleme: sistemler, amaçlar ve yaklaşımlar. arXiv [Ön baskı] arXiv:1912.07383v1. doi: 10.48550/arXiv.1912.07383
- Crossref
- Google Scholar
-
Salunkhe T., Jamadar N. I., Kivade S. B. (2018). Mekanik bileşenlerin kalan kullanışlı ömrünün tahmini: bir değerlendirme. Int. J. Mech. Eng. Technol. 9, 125–135.
- Google Scholar
-
Sriram S., Karthikeya C. H., Kumar K. P. K., Vijayaraj N., Thangavel M. (2024). Yerel LLM’lerin, prompt tabanlı ajan sınıflandırmasıyla güvenli sistem içi görev otomasyonunda kullanımı. IEEE Access 12, 177038–177049. doi: 10.1109/ACCESS.2024.3505298
- Crossref
- Google Scholar
-
Touvron H., Martin L., Stone K., Albert P., Almahairi A., Babaei Y. ve diğerleri (2023). Llama 2: açık temel ve ince ayarlanmış sohbet modelleri. arXiv [Ön baskı]. arXiv:2307.09288. doi: 10.48550/arXiv.2307.09288
- Crossref
- Google Scholar
-
Vaswani A., Shazeer N., Parmar N., Uszkoreit J., Jones L., Gomez A. N. ve diğerleri (2017). Dikkat her şeydir; siz de ihtiyacınız var. Adv. Neural Inf. Process. Syst 30, 5998–6008.
- Google Scholar
-
Wahid A., Breslin J. G., Intizar M. A. (2022). Endüstri 4.0’da makine arızasının tahmini: hibrit CNN-LSTM çerçevesi. Appl. Sci. 12:4221. doi: 10.3390/app12094221
- Crossref
- Google Scholar
-
Yugesh R. P., Lakshmi G., Brindha S., Sriram S. V., Padmanabhan B. A. (2024). Dayanıklılığı sağlamak: fiber optik ağlarda IoT tabanlı arıza tespiti, 2024 Uluslararası İletişim, Hesaplama ve Nesnelerin İnterneti Konferansı (IC3IoT). Chennai: IEEE. 1–510.1109/IC3IoT60841.2024.10550388
- Crossref
- Google Scholar
-
Zhang W., Yang D., Wang H. (2019). Endüstriyel ekipmanların tahminli bakımı için veri odaklı yöntemler: bir inceleme. IEEE Syst. J. 13, 2213–2227. doi: 10.1109/jsyst.2019.2905565
- Crossref
- Google Scholar
Özet
Anahtar Kelimeler
ERP bakım verileri, ekipman arıza tahmini, büyük dil modelleri, çevrimdışı sohbetli yapay zeka, tahmine dayalı bakım, rastgele orman, SAP tesis bakımı
Atıf
Sriram S, Vijayaraj N, Balabommu H ve Choudhary G (2026) Sohbet arayüzüyle tahmine dayalı bakım sistemi. Front. Artif. Intell. 9:1930680. doi: 10.3389/frai.2026.1930680
Alındı
07 Temmuz 2026
Gönderildi
30 Eylül 2026
Kabul edildi
30 Eylül 2026
Yayınlandı
11 Kasım 2026
9 – 2026
Ravdeep Kour, Luleå Teknoloji Üniversitesi, İsveç
Ali Albashir Mohammed Alhaj, King Khalid Üniversitesi, Suudi Arabistan
Praneeth Chandran, Luleå Teknoloji Üniversitesi, İsveç
© 2026 Sriram, Vijayaraj, Balabommu ve Choudhary.
Bu açık erişimli makale, Creative Commons Atıf Lisansı (CC BY) koşulları altında dağıtılmaktadır. Başka forumlarda kullanım, dağıtım veya çoğaltma, orijinal yazarların ve telif hakkı sahiplerinin belirtilmesi ile bu dergideki orijinal yayının atıf yapılması koşuluyla izin verilir. Bu koşullara uymayan hiçbir kullanım, dağıtım veya çoğaltma izni verilmez.
*İletişim: Nivethitha Vijayaraj, v_nivethitha@ch.amrita.edu
Bu makalede ifade edilen tüm iddialar yalnızca yazarların kendilerine aittir ve gerek affili oldukları kuruluşların, gerek yayıncının, gerek editörlerin ve gerek değerlendiricilerin görüşlerini yansıtmaz. Bu makalede değerlendirilebilecek herhangi bir ürün veya üreticisinin yapabileceği herhangi bir iddia, yayıncı tarafından garanti edilmez veya onaylanmaz.